📄 論文サマリー
著者:Fernando Dupin da Cunha Mello、Prashant Kumar、Erick G. Sperandio Nascimento
発表:arXiv(機械学習)/2609.38447v1
公開日:2026年09月29日
✨ 本論文の新規性
- リモートセンシング等の高コスト入力を排除し、気象データと2つの静的コンテキストのみで構成
- TransformerやMambaなど6種の時系列エンコーダを同一条件で比較し、公平な性能評価を実現
- 空間インスタンス展開(SIE)により、市町村単位の収量データ不足を補い過学習を抑制
論文の主張: ブラジル大豆を対象に、気象データと簡易な地域情報だけで全国規模の収量を予測するフレームワークを提案。Transformerモデルが農家の基準比で誤差を約48%低減し、運用可能な精度を達成した。
今回ご紹介するのは、ブラジルの大豆収量予測に関する最新の研究論文です。「先端農業マガジン」では、海外の農業テック動向を追っていますが、これは「インプット節約型」と呼ばれる独自の深層学習フレームワークを提案しています。注目すべきは、複雑な土壌情報や管理履歴を使わず、通常の気象データとわずかな静的コンテキストのみで高精度な予測を実現した点ですね。
なるほど、気象データだけでそこまでできるんですか。データ収集のコストやハードルが下がるのは魅力ですが、精度の信頼性はどうなんでしょう。特に印象に残った点はどこですか?
はい、ここが面白いところでして。2001年から20年間のデータを用いた検証で、トランスフォーマーモデルが従来の「農家の5年移動平均」ベースラインに対し、誤差を約47%削減しました。RMSE(平方平均二乗誤差)は149キログラム毎ヘクタール、決定係数R²は0.784という結果が出ています。
誤差が半分以下ですか。数字としてはかなりインパクトがありますね。でも、気象データって無料のものが多いとはいえ、加工や整備に手間がかかるイメージがあります。本当に「節約」できているんですか?
そこが設計の肝なんです。このフレームワークは「アーキテクチャ非依存」で、データ要件を最小限に抑えています。さらに「空間的インスタンス拡張」という手法を使い、自治体単位の収量に対し、その中の複数の気象グリッドデータを紐付けることで、過学習を防ぎつつサンプル数を増やしています。外部データの依存度を極限まで低くしているんですね。
なるほど、工夫でデータ不足を補っているわけですね。ただ、ブラジルは農業大国とはいえ、気候変動の影響も大きいですよね。このモデル、長期的なトレンドには対応できているんですか?
SHAPという説明可能AI手法での分析によると、「作付け年」が長期的な傾向の大部分を説明し、気象要因は年ごとの変動を主に駆動していることが示唆されています。つまり、技術進歩や品種改良といった「時間軸の変化」と、その年の「天候不順」をモデルがうまく分離して捉えているわけです。
それは理にかなっていますね。現場の感覚としても、今年は雨が多かったとか、逆に乾燥したとかいう「今年特有」の変動と、長期的な生産性向上は別物ですから。この分離ができているなら、実務的な予測ツールとして使えそうです。
ええ、さらに「シーズン内予測」の精度向上にも注目です。季節が進むにつれて予測誤差が単調に改善し、最終時点ではベースライン比で約50%低い誤差に達しています。これは、作付け後の気象予報を組み込むことで、早期の意思決定支援にもなり得ることを意味しています。
シーズン内で精度が上がっていくのは、在庫管理や先物取引のタイミングを計る上ではありがたいですね。ただ、こうした高度なAIモデルを運用するには、結局はシステム維持のコストや専門人材が必要になります。小規模農家への普及は難しいのでは?
そこが課題ですね。論文では「簡潔で移転可能」であることを強調していますが、実運用では気象予報データとの統合や、地域ごとの「農業環境ラベル」の整備が必要になります。特に、このラベルが土壌や品種の代わりを果たしているため、地域性が強い国ではラベル定義そのものが難しいという指摘もあります。
確かに、ブラジルと日本では農地の区画や作物の多様性が異なりますから、そのまま持ち込むのは難しいでしょうね。ただし、大規模な穀物生産地や、輸出向けのサプライチェーン管理においては、こうした「外部データ依存の少ない」モデルは、コスト効率という点で検討の余地がありそうです。
はい、完全な自動化を目指すのではなく、既存の予測システムを補完する「軽量な代替手段」として捉えるのが現実的かもしれません。メリットはデータ取得の簡易性とスケーラビリティ、一方で課題は地域適応と運用体制の整備、というバランスですね。
技術の「軽さ」を追求した良い事例だと思います。導入するか否かは、地域特性と経営規模で判断が分かれそうです。今日はここまでです。
ええ、選択肢の一つとして、注目しておきたいテーマですね。
背景と課題:データ不足と複雑さの壁
食料安全保障や市場安定化には、信頼性の高い収量予測が不可欠だが、従来の手法には課題があった。統計モデルは非線形な気象影響を捉えきれず、プロセスベースモデルは土壌や管理データなど詳細なローカル情報を必要とし、国全体へのスケーリングが困難だった。また、高性能な機械学習モデルは衛星画像などの高コスト・高頻度データを前提とすることが多く、再現性や運用の簡便さに欠けるという「入力データの壁」が存在した。本研究は、これらの制約を克服し、誰でも再現・運用できる簡素なデータ構成での高精度予測を目指した。
手法:気象データのみで構成する軽量フレームワーク
提案手法は、時系列入力として「気象データ」のみを使用し、静的コンテキストとして「作付け年」と「農業環境ラベル(地域区分)」の2項目を加えた最小限の入力構成を持つ。時系列エンコーダには、MLP、CNN、LSTM、CNN-LSTM、Transformer、Mambaの6種を実装し、同一のデータと融合戦略で比較検証した。さらに、市町村単位の収量データに対し、その区域内の複数の気象グリッドノードを紐付ける「空間インスタンス展開(SIE)」を導入。これにより、合成データを作らずに訓練サンプル数を増やし、地域内の微細な気象変動を学習させつつ、過学習を防ぐ設計となっている。
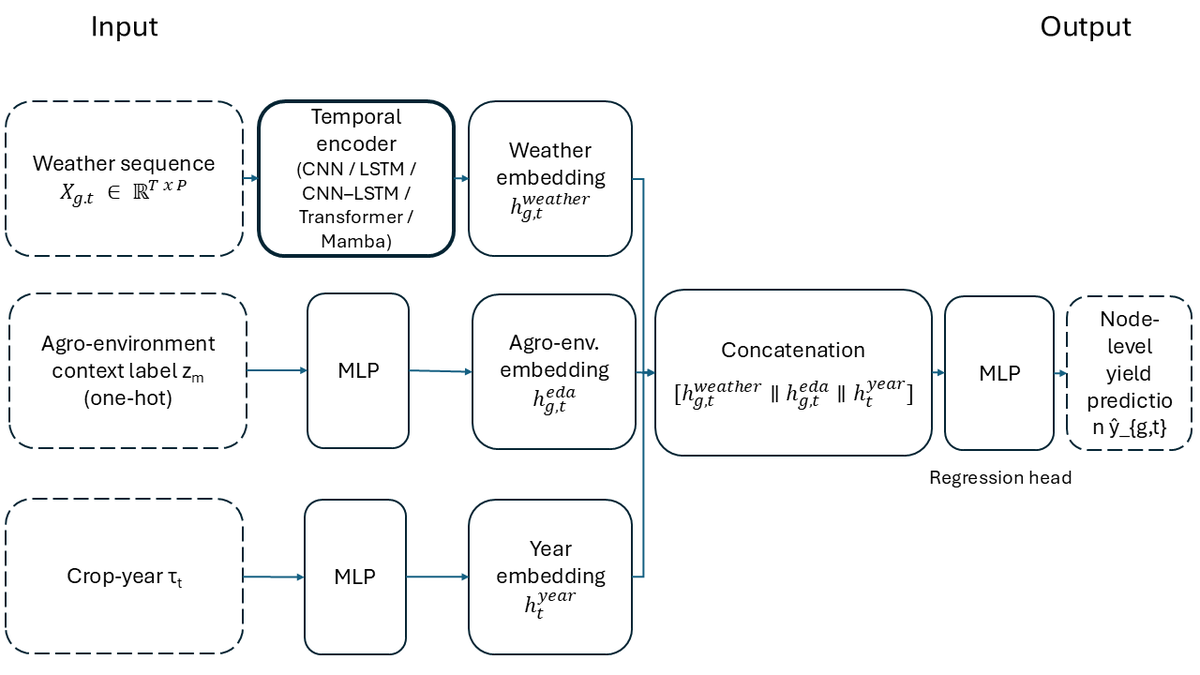
実験結果:Transformerが農家基準比で誤差47.6%減
ブラジル全土の大豆20シーズン(2001/02〜2020/21)を対象に検証を実施した。結果、すべての深層学習モデルが線形回帰モデルを上回り、時系列構造を考慮したモデルがMLPを上回った。特にTransformerモデルが最良の精度を示し、全国集計値におけるRMSEは149 kg/ha、決定係数R²は0.784を記録した。これは、過去5年の平均値を用いる「農家基準」の予測誤差と比較して47.6%の削減に相当する。また、生育期間中の早期予測から後期予測にかけて精度が単調に向上し、最終段階では基準比で約50%の誤差低減を達成した。
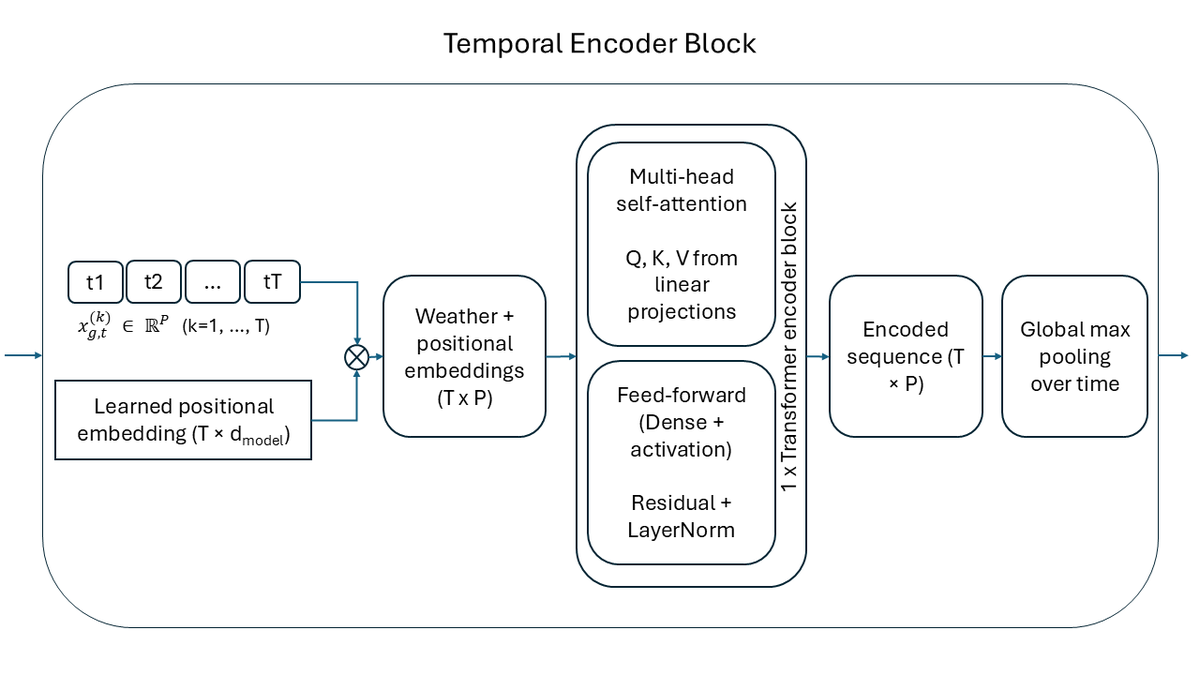
意義と応用:他作物・他地域への展開可能性
本フレームワークは、グローバルに入手可能な気象データと簡易な地域分類のみで動作するため、ブラジル以外の国や他の作物への転用が容易である。SHAP解析により、長期的な収量トレンドは「作付け年」が、年ごとの変動は「水分・雲量」および「熱需要」などの気象変数が支配していることが示唆された。この知見は、気象予報データと組み合わせることで、収穫前のリスク管理や市場価格の安定化に貢献する。複雑なセンサー網や衛星データへの依存を減らすことで、開発途上国を含む広範な地域での導入コストを低減できる点が大きな利点である。
限界と今後の課題
本研究は気象データのみを用いるため、灌漑設備の有無や施肥量、品種改良の具体的な詳細といった「管理情報」の影響を直接は捉えられない。農業環境ラベルが粗い分類である場合、局所的な微細な管理差異による収量変動を完全に説明できない可能性がある。また、ブラジル大豆という特定作物・地域での検証であり、気候帯や作物生理が異なる環境での汎用性については、さらなる検証が必要である。今後は、利用可能な範囲で管理データを追加する拡張性や、より高頻度な気象予報との連携による早期警報システムの構築が課題となる。
日本での適用可能性
日本では、コメや小麦などの主作物の収量予測に活用できる可能性がある。気象庁のメッシュ気象データや、農林水産省の地域別作付け情報(農業環境ラベルの代替)を用いることで、国内の広域予測モデルを構築可能である。特に、気候変動による異常気象(猛暑や豪雨)が収量に与える影響を定量化し、生産者への栽培指導や、流通段階での在庫調整に役立てられる。小規模なデータセットでも学習可能な軽量設計のため、地方自治体やJAなどの現場レベルでの導入も現実的である。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: An Input-Frugal Deep Learning Framework for Weather-Driven National Crop-Yield Forecasting: A Case Study of Brazilian Soybean – 著者: Fernando Dupin da Cunha Mello, Prashant Kumar, Erick G. Sperandio Nascimento – 発表日: 2026-09-29 – arXiv ID: 2609.38447v1 – カテゴリ: cs.LG