📄 論文サマリー
著者:Julia Simon、Daniel Steininger、Andreas Trondl
発表:arXiv(コンピュータビジョン)/2610.32289v1
公開日:2026年10月23日
✨ 本論文の新規性
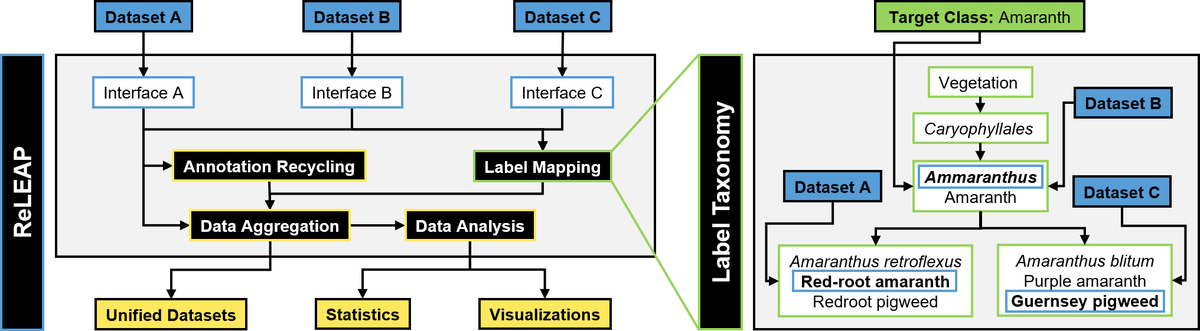
- 15の異なる農業画像データセットを階層的分類体系で統合し、アノテーション形式の差異を解消するPythonフレームワークReLEAPを開発した。
- 既存の低レベルアノテーションを再利用し、SAM 3や独自モデルを用いてインスタンスセグメンテーション等の高レベルアノテーションを自動生成する手法を実装した。
- 教師なしから半教師ありまでの多様な設定で評価を行い、統合データによる学習が単一データセット学習よりも精度と効率の両面で優位であることを実証した。
論文の主張: ReLEAPは、形式が異なる15の農業画像データセットを統合し、既存アノテーションを再利用して高レベルなアノテーションを自動生成するフレームワークです。統合データによる学習とSAM 3等の活用により、手動アノテーションの負担を軽減し、データ活用効率を大幅に向上させます。
今回紹介するのは、ReLEAPというフレームワークに関する論文です。オーストリア工科大学のチームが開発したもので、異なる形式や定義を持つ画像データセットを統合し、既存のアノテーションを新しい学習タスクで再利用できるようにする仕組みなんですよね。
なるほど、データの再利用が主眼なのですね。特に印象に残ったポイントはどこですか?
精密農業を例に、15もの異なるデータセットを統合した点が興味深いです。植物種やアノテーション形式がバラバラでも、階層化された分類体系にマッピングすることで、半教師あり学習などで高次のラベルを自動生成できるという実証を行っています。
データ収集のコスト削減という文脈では魅力的ですね。ただ、精度の担保はどうしているのでしょうか。
教師なしや弱教師ありの設定で、既存モデルを使ってアノテーションを拡張する『アップサイクリング』という手法を用いています。統一データで訓練したモデルと基盤モデルを組み合わせて、ラベル付けの効率を上げるアプローチですね。
つまり、人力での細かなラベル付けを減らせる可能性があると。労務コストの観点では大きなメリットですね。
ええ。ただし、異なる環境条件や成長段階で視覚的に類似した植物を区別するのは依然として難しい課題です。このフレームワークはデータ透明性を高め、持続可能なモデル訓練を支援しますが、万能というわけではありません。
技術的な統合が進む一方で、現場での運用コストは気になるところです。Pythonで実装されているとのことですが、導入のハードルは低いですか?
オープンソースとして公開されており、データソースの抽象化により新規データの追加がしやすい設計になっています。研究者向けにスケーラブルな構造を提供していますね。
アカデミック用途での活用が想定されているのですね。商業的なプラットフォーム化には、まだ時間がかかりそうです。
データ分断が解決されれば、希少種などのデータ不足を補える可能性があります。一方で、既存データの質が統一されない限り、モデル性能には限界があるという指摘もあります。
データの質と量のバランスが鍵ですね。技術的な可能性と、実務での採算性、その両面を見極める必要があります。
その通りです。既存資産の再活用という視点では有益なツールですが、適用範囲はデータセットの特性に依存します。
メリットも課題もある取り組みですが、選択肢の一つとして注視しておきたいですね。ありがとうございました。
背景と課題
精密農業では、作物や雑草の細かな差異を識別するために大量のアノテーション付きデータが必要ですが、収集には多大な時間と専門知識を要します。既存の公開データセットも、アノテーション形式やラベル定義、対象タスクが異なるため、そのまま統合して利用することは困難でした。このデータの断片化により、特定のタスクやクラスに対する学習データが不足し、新規モデル開発の障壁となっていました。
手法・アプローチ
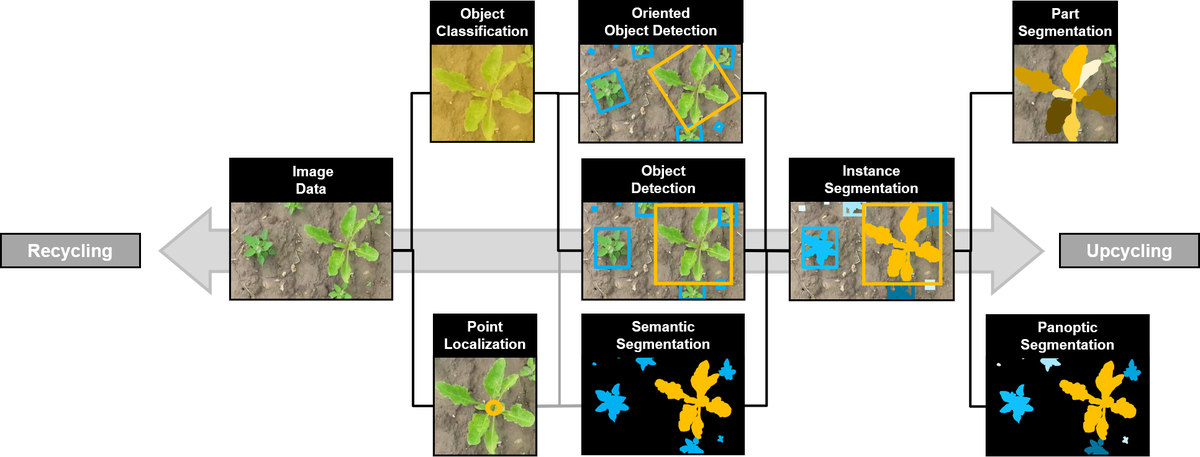
本研究では、ReLEAPというフレームワークを提案します。ReLEAPは、異なるデータソースを抽象化し、階層的な分類体系を用いてラベルを統合します。さらに、既存のアノテーションを規則に基づいて変換するリサイクリングと、SAM 3や独自学習モデルを用いて高レベルアノテーションを生成するアップサイクリングを実装しました。これにより、分類データから検出データへ、あるいはバウンディングボックスからセグメンテーションマスクへと、データの利用範囲を自動的に拡張します。
実験結果
15の農業データセットを用いた評価では、統合データによる学習が単一データセット学習よりも優れた性能を示しました。クラス非依存のマスク生成において、ReLEAPで訓練したモデルはSAM 3と比較して推論速度で14倍以上の高速化を達成しつつ、精度でも上回りました。また、バウンディングボックスなどの事前情報を用いた半教師あり設定では、mAP50-95が平均43.1%となり、教師なし設定の9.2% compared to 43.1%を大きく上回りました。
意義・応用可能性
ReLEAPは、既存の断片化したデータ資源を有効活用し、新規データ収集のコストを削減します。特に、アノテーションが不足しているニッチな作物や雑草の識別において、既存データからの知識転移が有効です。オープンソースとして公開されており、研究者や開発者が異なるデータソースを容易に統合し、持続可能なモデル開発を行える基盤を提供します。
限界と今後の課題
自動アノテーションの精度は、訓練データに含まれるクラスと対象データのクラスとの一致度に依存します。訓練データに存在しない希少種や、極端に異なる環境条件では性能が低下する傾向が見られました。また、SAM 3などの基盤モデルを用いる場合、推論コストが高くなる場合があります。今後の課題は、より多様な環境下での汎用性向上と、推論効率のさらなる最適化です。
日本での適用可能性
日本では、多品種の野菜や果物、地域特有の雑草に対する精密農業の需要が高まっています。ReLEAPのようなフレームワークは、国内で蓄積された多様な農業画像データを統合し、アノテーションコストを抑えながら高精度な識別モデルを開発するのに有用です。特に、人手不足が深刻な現場において、自動アノテーション支援は導入のハードルを下げる可能性があります。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: ReLEAP: Upcycling Vision Datasets through Cross-Task Unification and Semi-Supervised Annotation – 著者: Julia Simon, Daniel Steininger, Andreas Trondl – 発表日: 2026-10-23 – arXiv ID: 2610.32289v1 – カテゴリ: cs.CV