✨ 本論文の新規性
- PPOの最適化規則を変更せず、収穫特有の空間制約と軌道安全性を組み込んだ新フレームワークPSA-PPOを開発した
- Isaac Labでのシミュレーション学習のみでポリシーを構築し、実機での微調整なしにUR10eへ転送することに成功した
- 終点精度だけでなく、側面からの進入経路と軌道履歴に基づく安全性を評価指標に含めた点で従来の手法と異なる
論文の主張: 水耕レタスの収穫において、シミュレーション環境のみで学習した強化学習ポリシーを実機へ転送し、側面からの安全な接近を実現した。従来手法比で到達率94.7%、振動を最大73%低減し、実環境での安定収穫を可能にした。
今回紹介するのは、2026年10月に公開された論文で、水耕栽培のレタスを収穫するロボットの制御技術に関する研究です。テキサスA&M大学のチームが、シミュレーション環境での学習のみで実機への転用を成功させた「PSA-PPO」という手法について報告しています。
シミュレーションだけで実機が動くとは、興味深いですね。水耕栽培は設備が複雑で、従来のロボットでは動作が硬くなりがちだと聞きますが、この研究は何が特別だったのでしょうか。
従来の強化学習は、最終的な到達点を重視しがちで、途中の安全性や滑らかさが軽視されることがありました。この研究では、作物や装置に接触しない「通路」を考慮した安全制御を組み込み、急激な加減速を抑えることで、物理的な損傷リスクを減らしています。
なるほど、精度だけでなく「動きの質」を評価しているわけですね。従来の手法と比べて、実際の収穫成功率や動作の安定性にはどのような差が出ましたか。
150回の標的到達テストでは、この手法は94.7%の成功率を記録しました。これは従来手法の80%台前半を上回っています。また、動作の急激さを示す指標である「ジャーク」を、最終接近段階で約40%から73%削減していることもデータで示されています。
数字としてはかなりインパクトがありますね。従来手法との差が明確に出ているようです。ただ、シミュレーション環境でこの精度が出るのは理解できますが、実際の温室での検証はどうだったのでしょうか。
実機での評価も実施されており、144回の収穫試行において、視覚情報に基づく目標到達が94.4%、完全な収穫成功が86.1%と報告されています。シミュレーションでの学習だけで実機に転用し、追加の微調整を行わなかった点が重要視されています。
実機での微調整なしで8割超の成功とは、現場導入のハードルが下がりますね。ただ、初期投資や導入コストの面ではどうなんでしょう。高機能な制御ソフトを積むことで、機器自体のコストが上がらないか気になります。
論文自体は制御アルゴリズムの優位性を示すものですが、ハードウェアとしては一般的な産業用ロボットアームであるUR10eが使用されています。特殊な専用機ではなく、既存の汎用ロボットにこのソフトウェアを適用する形ですので、ハードウェアのコスト増は限定的と考えられます。
汎用ロボットで対応できるなら、導入の敷居は低そうです。一方で、日本の水耕栽培は作物の種類やハウス構造が海外と異なりますよね。この手法が日本の環境でもそのまま通用するのか、移植性はどのくらいあるのでしょうか。
この手法は「通路」や「回避すべき領域」を学習させるため、環境の形状が異なれば再学習が必要になる可能性はあります。しかし、シミュレーション環境の設定を変えるだけで対応できる柔軟性があり、異なる作物やレイアウトへの適応も期待されています。
再学習の手間はあるものの、シミュレーションで済むなら現実的ですね。ただ、農業経営の観点では、この技術がどの程度の規模感で採算が取れるかが鍵になりそうです。小規模な温室では投資対効果が薄いかもしれません。
確かに、大規模な生産現場での自動化を前提とした研究です。人手不足への対応と安定した品質維持というメリットがある一方で、初期導入費用やシステム維持のコストを回収できる規模であるかが、導入判断の分かれ目になるでしょう。
規模次第という点は、多くの農業自動化技術に共通する課題ですね。メリットと課題を踏まえると、導入を検討する現場にとっては、まずは小規模な実証実験から始めるのが賢明かもしれません。
その通りです。技術的な可能性は高いですが、現場への適用には環境条件や経済性を含めた慎重な検証が不可欠です。興味のある方は、元論文の詳細なデータもぜひ確認してみてください。
背景と課題
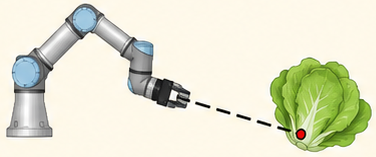
水耕栽培のレタス収穫では、密集した作物や栽培設備の中で、茎根部へ正確にカッターを導く必要がある。従来の逆運動学やサンプリングベースの計画手法は、終点の位置精度は高いものの、接近中の軌道が隣接作物や設備に接触するリスクや、急激な加減速による振動を十分に制御できない場合があった。また、実機での試行錯誤による学習は、作物の損傷や装置故障のリスクが高く、大規模なデータ収集が困難である。
手法:PSA-PPOによる安全な側面接近
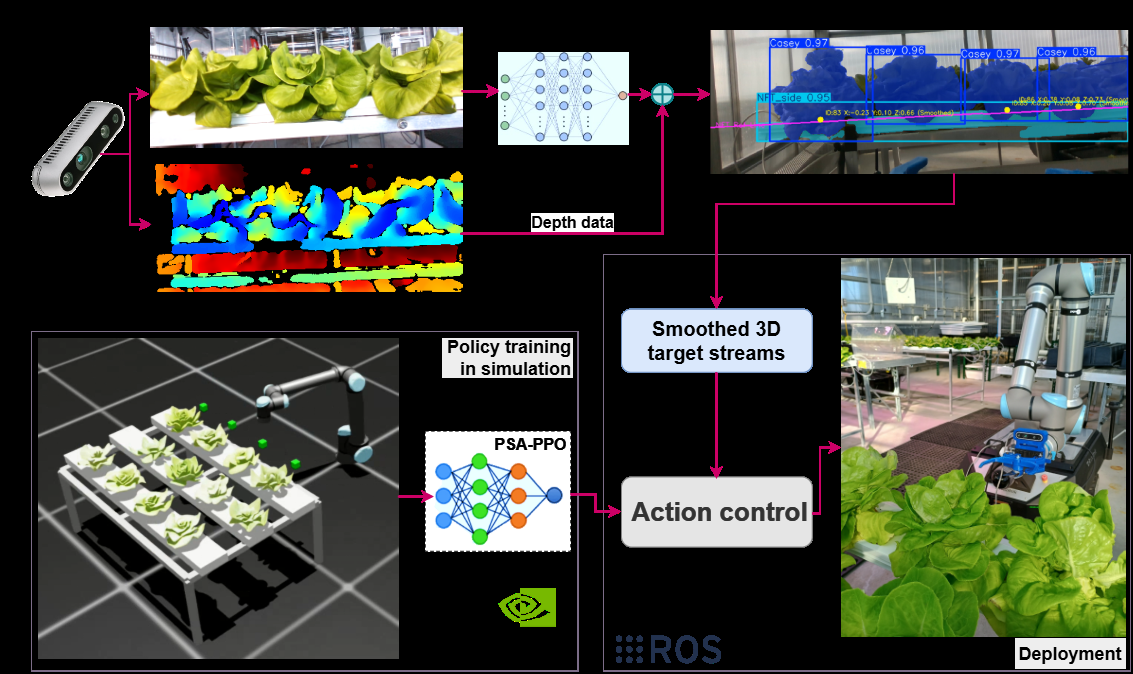
本研究では、Proximal Policy Optimizationの標準的な最適化規則を維持しつつ、収穫タスクに特化した「PSA-PPO」を開発した。この手法は、目標点に対する側面からの進入方向や、栽培設備からのクリアランスを考慮した観測値を用いる。さらに、軌道履歴に基づく安全性エンコーディングを導入し、終点到達だけでなく、移動経路全体での衝突回避とツール姿勢の維持を報酬関数に組み込んだ。学習はNVIDIA Isaac Lab上のGPU並列シミュレーション環境で完結し、実機での微調整は行わない。
実験結果:実機での高到達率と低振動
物理的なUR10eロボットアームを用いた150回のベンチマークテストでは、PSA-PPOは94.7%の到達率を記録し、Cartesian+TOTG(86.0%)やRRTConnect(88.0%)といった従来手法を上回った。最終接近区間におけるRMS jerk(振動の激しさ)は、従来手法比で39.8〜73.0%低減し、滑らかな動作を実現した。また、温室環境での144回の収穫試験では、視覚ガイド付きの到達成功率94.4%、完全収穫成功率86.1%を達成した。
意義と応用可能性
シミュレーションのみでの学習と実機転送の成功は、農業ロボットの開発サイクルを大幅に短縮する可能性を示す。実機での試行錯誤を最小限に抑えつつ、複雑な環境下での安全な動作を確保できるため、既存の温室設備への導入コストとリスクを低減できる。特に、損傷しやすい葉物野菜の収穫において、振動抑制と衝突回避の両立は、収穫品質の向上と機械トラブルの防止に直結する。
限界と今後の課題
本研究では、シミュレーションと実機の間の物理的な差異(Reality Gap)を、固定された補正パラメータとROS層での安全装置で吸収している。しかし、作物の形状変化や環境光の急激な変動に対するロバスト性は、さらなる検証が必要である。また、現在の評価は制御された環境および特定のレタス品種に限定されており、多品種や屋外環境への拡張には、視覚モジュールの強化とポリシーの適応性が問われる。
日本での適用可能性
日本では、高設栽培や植物工場でのレタス生産が普及しており、人手不足への対応としてロボット収穫への関心が高い。本手法は、既存のUR10eなどの汎用ロボットアームとRGB-Dカメラで構成可能であり、大規模な設備改修を必要としない。シミュレーションでの事前検証により、導入時のリスクを低減できる点は、保守体制が限られる日本の農業現場にとって実用的である。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: Sim-to-Real Reinforcement Learning for Path-Safe Target Reaching in Robotic Harvesting of Hydroponic Lettuce – 著者: Al Bashir, Partho Ghose, Yibin Wang, Robert G. Hardin, Joshua Peeples, Genhua Niu, Azlan Zahid – 発表日: 2026-10-15 – arXiv ID: 2610.22337v1 – カテゴリ: cs.RO