📄 論文サマリー
著者:Shalini Dangi、Divya Teja、Omkar Kabde、Shahid Shafi Dar、Nagendra Kumar
発表:arXiv(コンピュータビジョン)/2610.17996v1
公開日:2026年10月13日
✨ 本論文の新規性
- Mean-Teacher構造に離散ウェーブレット変換(DWT)と教師付き対照学習を組み込み、限られた注釈データでも安定した学習を実現
- KLダイバージェンスを用いた擬似ラベル補正機構を導入し、未注釈データ由来のノイズと確認バイアスを低減
- 周波数領域の特徴抽出により、成長段階や環境で変化する病斑の微細な差異を捉え、クラス間の混同を抑制
論文の主張: サトウキビの葉病検出において、注釈付きデータが不足する課題に対し、Mean-Teacherモデルと離散ウェーブレット変換を組み合わせた半教師あり学習手法を提案。擬似ラベルの信頼性を高め、限られたデータで完全教師ありモデルに匹敵する精度を達成した。
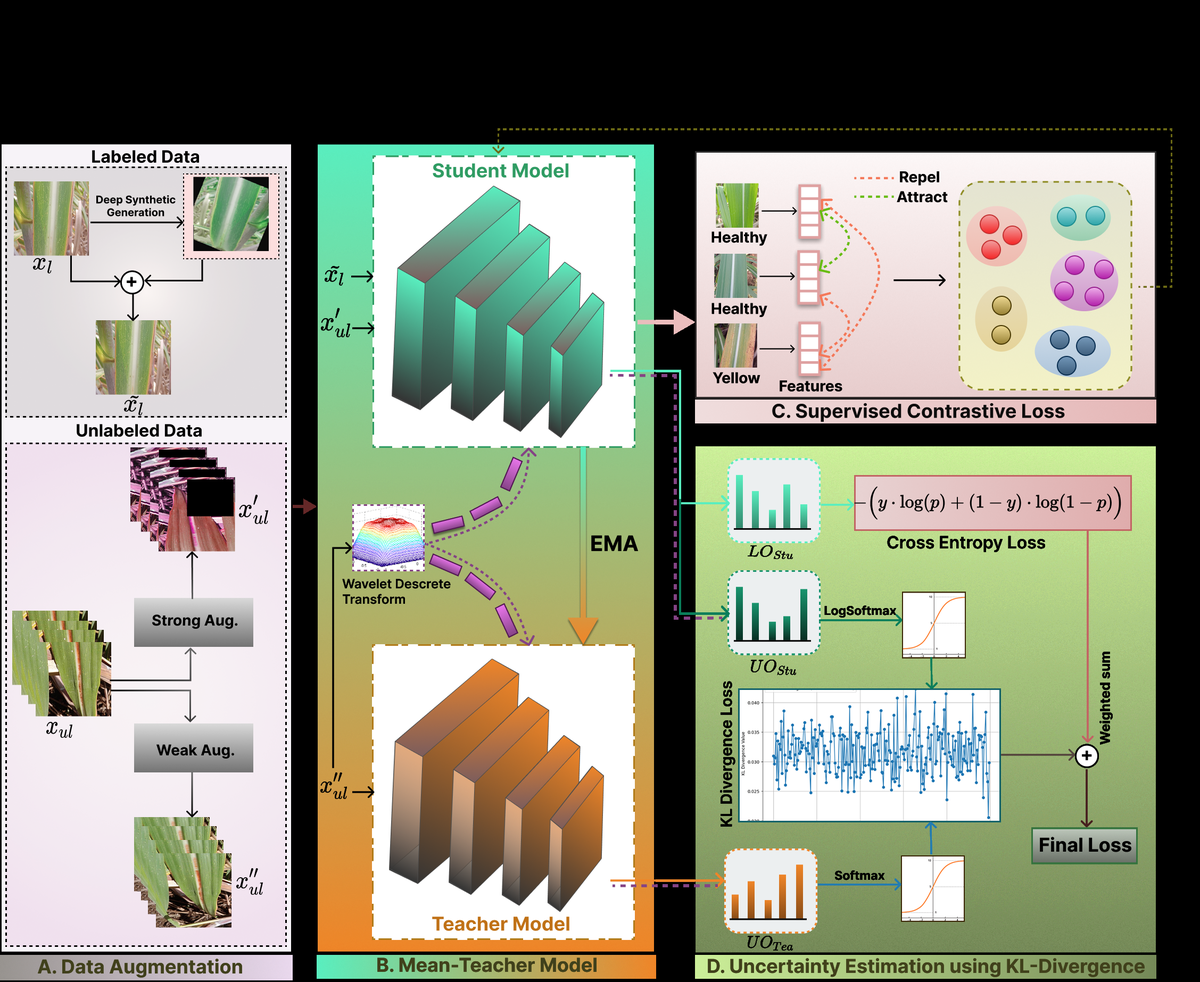
今回紹介するのは、インド工科大学インドル校らの研究チームが発表した論文です。サトウキビの葉の病気を検出するために、大量にアノテーションされたデータを使わずとも、半教師あり学習と対照学習を組み合わせた新手法「U-SSDNet」を提案しています。
なるほど、アノテーションの負担を減らすアプローチですね。農業現場では専門家の目視判断がボトルネックになりがちですから、これは実用的な視点があると思います。特に注目すべきポイントはどこでしょうか。
ここが面白いところです。離散ウェーブレット変換という画像処理技術を使って、病変部分の特徴を強調しています。これにより、健康な組織との見た目の差が微妙なケースでも、特徴量としての区別しやすさを高めているんです。
画像処理の前段階で工夫を凝らしているわけですね。単純なCNNの導入よりも、前処理でノイズや曖昧さを排除する方が、現場の誤検知率低減には直結しそうです。
加えて、KLダイバージェンスを用いて擬似ラベルの信頼性を補正しています。モデルが自信を持って付けたラベルでも、実際には間違っている場合がありますから、この確率的な不確実性を取り除く仕組みが組み込まれています。
不確実性の管理ですか。これはAIの「ハルシネーション」に近い問題への対策ですね。誤ったラベルが学習ループに混入すると、精度が下がるどころか逆効果になりかねませんから、ここが安定性の鍵になりそうです。
はい。そして教師あり対照学習を用いて、クラス間の分離性を強化しています。これにより、異なる病害同士の特徴が混同されるリスクを低減し、限られたラベルデータでも競合する手法を上回る性能を出せることを示しています。
数字としてはインパクトがありますね。ただ、研究段階での成果と、実際の広大な圃場での運用にはギャップがあるのが常です。この手法の計算リソースや、既存システムへの統合コストはどう見られていますか。
論文では、フル教師ありモデルに近い性能を、はるかに少ないアノテーションで達成できるとされています。計算コスト自体は明確な比較数字は提示されていませんが、半教師あり学習自体がラベル作成コストを削減する前提の技術です。
なるほど。ラベル作成のコスト削減が主眼ですね。サトウキビは収穫期が長く、病害の兆候も時期で変わるでしょうから、継続的な学習が可能なこの仕組みは、長期的な運用コストの抑制に寄与する可能性がありそうです。
サトウキビは世界的な砂糖生産の8割を占める重要な作物です。病害による収量減や品質低下を早期に検出できれば、経済的損失を抑えられます。ただし、この技術が現地の環境や農家の習慣にどう適合するかは、別の課題と言えます。
技術的な優位性と現場への適用可能性は、また別の議論ですね。導入には地域ごとの気候条件や、既存の農機具との連携といった現実的なハードルも考慮する必要があります。
おっしゃる通りです。この論文は、限られたデータでいかに精度を維持するかという技術的な挑戦に対する一つの回答を示しています。メリットは明確ですが、実運用での汎用性や維持コストについては、今後の検証が待たれます。
メリットも課題もある、バランスの取れた視点ですね。AI技術が農業の効率化にどう貢献するか、選択肢の一つとして注視していきたいテーマです。本日はありがとうございました。
背景と課題
サトウキビは世界生産の約8割を占める重要な作物だが、葉病が収量と糖度を著しく低下させる。従来のPCR検査や目視確認は精度が高いものの、コストと労力がかかり大規模農場での運用は困難だ。深層学習を用いた自動検出が注目されているが、高性能なモデルには大量の注釈付き画像が必要となる。農業現場では、成長段階や環境により同じ病気が異なる見た目になる「クラス内変動」や、健康な組織と病斑が似通う「クラス間類似性」が存在し、注釈作成が難しい。さらに、誤ったラベルがモデルの性能を損なうリスクもある。
手法・アプローチ
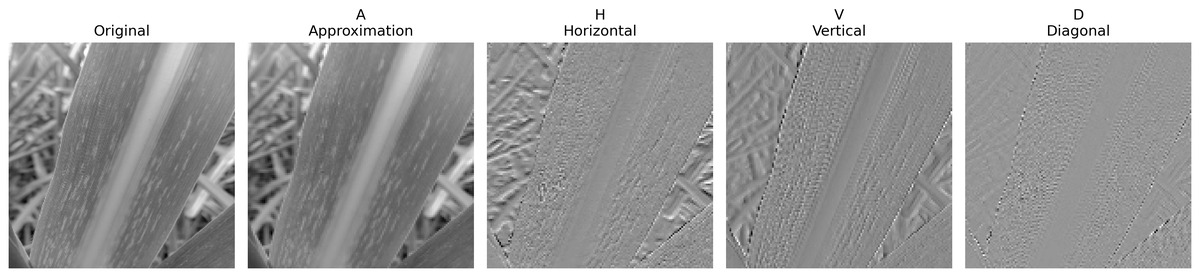
本研究では、U-SSDNetという半教師あり学習フレームワークを提案する。まず前処理として離散ウェーブレット変換(DWT)を適用し、画像を低周波成分と高周波成分に分解する。これにより、葉の全体構造と病斑特有の微細なテクスチャやエッジを分離して抽出し、クラス内変動の影響を軽減する。次に、EfficientNetB4をベースとしたMean-Teacher構造を採用し、教師ネットワークの指数移動平均で学生ネットワークを導く。未注釈データに対しては、KLダイバージェンスを用いて擬似ラベルの信頼性を評価・補正し、ノイズの影響を抑制する。さらに、教師付き対照学習(Supervised Contrastive Learning)を導入し、同一クラスの特徴を近づけ、異なるクラスの特徴を遠ざけることで、特徴表現の判別性を高める。
実験結果
サトウキビ葉病データセットを用いた評価において、提案手法は限られた注釈データのみで学習しても、完全教師ありモデルに匹敵する性能を示した。特に、注釈付きサンプルが極端に少ない設定において、従来の半教師あり手法や教師あり手法を上回る精度を記録した。DWTによる特徴抽出は、初期段階の病斑や微細な斑点の検出に有効であり、空間領域のみを扱うCNNの特徴抽出を補完する役割を果たした。KLダイバージェンスによる擬似ラベル補正は、誤分類の蓄積を防ぎ、学習の安定性を向上させることが確認された。
意義・応用可能性
本研究の成果は、専門家の注釈コストを大幅に削減しつつ、高精度な病害検出を可能にする点にある。農業現場では、すべての画像にラベルを付けることは現実的ではないため、未注釈データを活用できる半教師あり学習は実用的価値が高い。周波数領域の特徴を用いることで、環境光の変化や葉の向きによる影響を受けにくくなり、屋外での安定した運用が期待できる。この手法はサトウキビに限らず、他の作物の病害検出や雑草識別など、視覚的特徴が複雑な農業タスクへ転用可能である。
限界と今後の課題
提案手法は計算コストと精度のバランスに優れるが、DWT処理や対照学習の導入により、単純な教師ありモデルと比較して学習プロセスが複雑化する。また、評価は特定のサトウキビデータセットに依存しており、異なる地域や品種、撮影条件への汎用性については追加検証が必要である。擬似ラベルの信頼性評価にKLダイバージェンスを用いているが、極端にノイズが多いデータや、未知の病気が混在する環境では、補正機構が十分に機能しない可能性が残る。実運用では、リアルタイム処理の速度向上と、多様な環境下でのロバスト性検証が課題となる。
日本での適用可能性
日本ではサトウキビ生産が沖縄や鹿児島に集中しており、労働力不足と病害管理の効率化が課題となっている。本研究の手法は、ドローンやスマートフォンのカメラ画像から病害を早期に検出し、農薬散布の最適化に貢献できる。注釈データの少なさという日本の農業データ事情にも適合しており、既存の画像データを活用してモデルを構築しやすい。将来的には、他の高付加価値作物の病害検出へ展開することで、農業全体のデジタル化と収量安定に寄与する可能性がある。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: Uncertainty-Aware Semi-Supervised Framework with Supervised Contrastive Learning for Sugarcane Leaf Disease Detection – 著者: Shalini Dangi, Divya Teja, Omkar Kabde, Shahid Shafi Dar, Nagendra Kumar – 発表日: 2026-10-13 – arXiv ID: 2610.17996v1 – カテゴリ: cs.CV