✨ 本論文の新規性
- 豪州308圃場の実測データを用い、LLMによる土壌有機炭素濃度推定の信頼性を大規模に検証した
- 単位系の変換や粗粒分の有無といった物理的等価条件での計算精度の低下を定量的に特定した
- 濃度推定、蓄積量計算、圃場比較の3タスクで独立した評価軸を設け、単一指標化の危険性を示した
論文の主張: 大型言語モデル(LLM)の土壌有機炭素評価への適用性を検証した研究です。実測データとの比較、単位変換時の計算精度、類似圃場の識別能力を独立して評価し、AI出力を生態学的証拠として無検証で使うことのリスクを指摘しました。
今回紹介するのは、オーストラリアのクイーンズランド大学などによる研究で、大規模言語モデルが土壌有機炭素の評価にどの程度信頼できるかを検証したものです。
なるほど、AIの農業応用ですね。特に印象に残った検証ポイントはどこでしょうか。
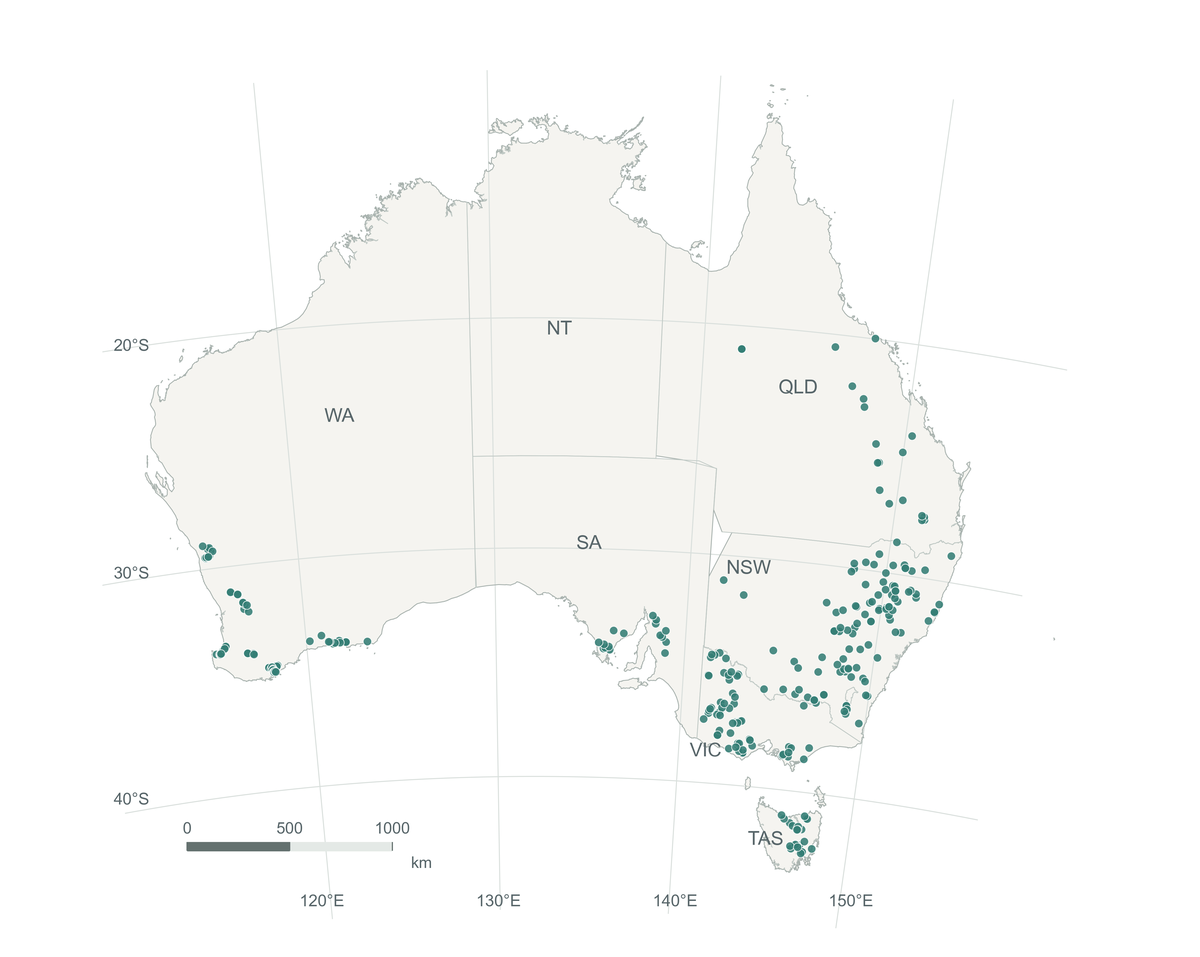
308のオーストラリアの牧区を対象に、土壌濃度の推定や炭素蓄積量の計算、牧区間の比較を行いました。その結果、追加の土壌データを与えることで、濃度推定の平均絶対誤差が13パーセントから62パーセント減少したというデータが出ています。
誤差が減るなら精度向上には寄与しそうです。ただ、実運用ではそのデータ収集自体にコストがかかりますよね。
そこが課題です。高精度なデータが必要になる一方で、高濃度の土壌では過少評価が残り、牧区ごとの誤差も継続しました。さらに、物理的に等価な単位に変換すると、計算精度が低下する傾向も見られます。
単位系で結果が変わるのは困りますね。現場では単位表記が揺らぐことも多いので、安定性が求められます。
はい。また、炭素蓄積量の計算では、砕石などの粗粒分を除いた単純な式では高い精度が出ましたが、条件が変わると落ちました。比較課題では、提示順序が結果に影響する場合もありました。
AIの入力設計が結果を左右するわけですね。API利用のコストや再現性も気になるところです。
研究では、API呼び出しのコストや、繰り返した際の出力のばらつきも独立した指標として評価しています。出力はほぼ全て解析可能でしたが、解析可能であることと正しいことは別問題だという指摘があります。
数字が整って見えることと、中身が正確であることは別物ですよね。経営判断に使うなら、その見極めが難しいです。
そうです。この研究は、測定値との一致、単位の一貫性、サイト間の識別能力という3つの異なる要件を満たす必要があることを示しています。
つまり、AIをそのまま証拠として使うのは危険だと。検証済みの計算フローが必要ですね。
その通りです。研究では、AIの出力を生態学的証拠として検証なしに使うのではなく、タスクごとの検証と監査可能な計算を支持するとしています。
AIは補助ツールとして位置づけるのが現実的ですね。導入には慎重さが必要な分野だと分かりました。今日はここまでです。
背景と課題
土壌有機炭素(SOC)は農業土壌の状態や炭素貯蔵量を評価する重要な指標ですが、その数値の正確性は管理判断に直結します。近年、大型言語モデル(LLM)が農業アドバイスやデータ分析に利用され始めていますが、流暢な回答が必ずしも正確とは限りません。既存のSOC予測は分光法や空間モデリングなど、実測データに基づいた手法が主流です。LLMをSOC評価に使う場合、実測値との一致度、単位系が変わっても計算結果が変わらないか、類似した圃場を正しく区別できるかといった、従来のベンチマークでは不十分な検証が必要です。本研究は、これらの潜在的な失敗モードを明確にするために設計されました。
手法・アプローチ
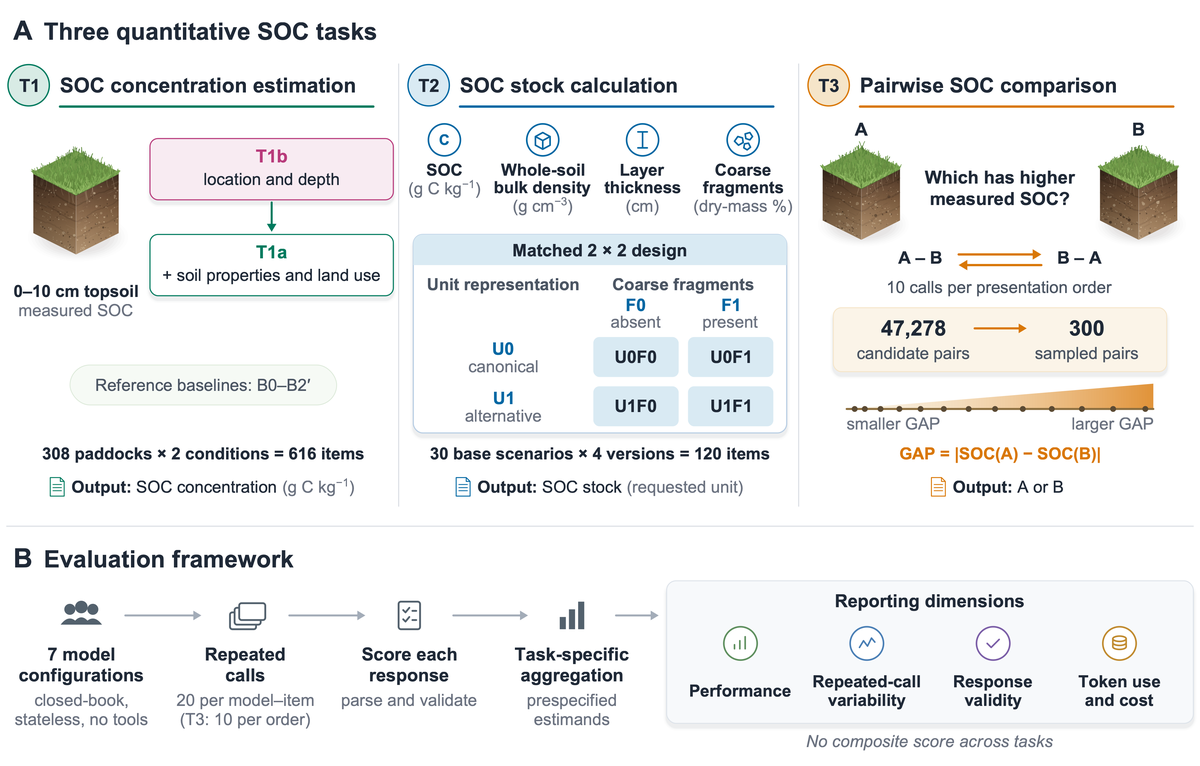
研究チームは、豪州の6州にある308の農業圃場から得られたSOC-Mデータセット(2022〜2025年採集)を使用しました。評価対象には、GPT-5.6 Sol、Claude Sonnet 5、Gemini 3.8 Flashなど、7つの異なるLLM構成を含めました。実験は3つのタスクに分類されます。T1では、座標や土壌特性などの情報を与え、0〜10cm層のSOC濃度を推定させました。T2では、与えられた式に基づきSOC蓄積量を計算させ、単位系や粗粒分の条件を変えた場合の精度を調べました。T3では、2つの圃場のうちどちらのSOC濃度が高いかを判定させ、提示順序や濃度差の影響を検証しました。各回答は外部ツールや会話履歴を使わない独立したAPI呼び出しで行い、再現性とコストも記録しました。
実験結果
T1の濃度推定では、土壌密度やpHなどの追加情報を与えることで、平均絶対誤差(MAE)が13〜62%減少しました。Gemini 3.8 FlashとGrok 4.6が最も低い誤差(3.62および3.82 g C kg-1)を示しましたが、高SOC濃度の圃場では過小評価の傾向が残りました。T2の蓄積量計算では、標準的な単位系で粗粒分がない条件では6構成中6構成が92.8〜100%の精度を達成しました。しかし、物理的に等価な別の単位系に変換すると、精度は21.6〜45.2ポイント低下しました。T3の圃場比較では、全体的な正答率は90.5〜94.6%と高かったものの、SOC濃度の差が小さい52ペアでは正答率が59.1〜70.9%まで低下し、提示順序の影響も確認されました。
意義・応用可能性
本研究は、LLMをSOC評価に直接使用する際のリスクを具体的に示しました。AIの出力が「解析可能」であることと「正しい」ことは別問題です。特に、単位系の変換や粗粒分の補正といった物理的な文脈が加わると、計算精度が著しく低下する傾向が見られました。これは、AIが数値処理を行う際に、物理的な意味よりも表面的なパターンに依存している可能性を示唆します。農業現場では、カーボンクレジットの算定や施肥計画にSOC値を用いるため、AIの出力をそのまま信用することは危険です。本研究が提唱する「タスク別の検証」と「監査可能な計算」の枠組みは、AI支援ツールを開発・導入する際の重要な基準となります。
限界と今後の課題
本研究にはいくつかの限界があります。T1の検証では、LLMの推定値と実測値の比較のみを行い、従来の機械学習モデルとの直接比較は空間的な交差検証の観点から厳密な対等条件ではありませんでした。また、LLMのプロバイダー側でモデルバージョンが更新される可能性があり、結果の再現性には時間的な制約があります。さらに、本研究は「閉じた本(closed-book)」での評価であり、外部データベースへのアクセスや計算ツールを利用したワークフローは検証されていません。今後は、検索拡張生成(RAG)や計算ツールを組み合わせたハイブリッドなAIシステムの精度検証が必要です。
日本での適用可能性
日本でも土壌有機炭素の蓄積量評価は、カーボンクレジット市場やスマート農業の推進において注目されています。本研究の知見は、日本の農業現場でAIツールを導入する際のガイドラインとして活用できます。特に、単位系の変換(例えば、kg/haへの換算)や、石礫率などの土壌特性を考慮した計算を行う際に、AIの出力を人間がダブルチェックする体制を整えることが重要です。日本の土壌は豪州とは異なる特性を持つため、国内の圃場データを用いた同様のベンチマークを実施し、国内向けに調整されたAIモデルの信頼性を確認することが望まれます。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: How Reliable Are Large Language Models for Soil Organic Carbon Assessment? An Australian Benchmark – 著者: Yingxuan Cheng, Tong Li, Yayong Li, Yuchuan Fan, You-Gan Wang, Jinran Wu, Scott Chapman, Geoffrey J. McLachlan – 発表日: 2026-10-13 – arXiv ID: 2610.18201v1 – カテゴリ: cs.PF