✨ 本論文の新規性
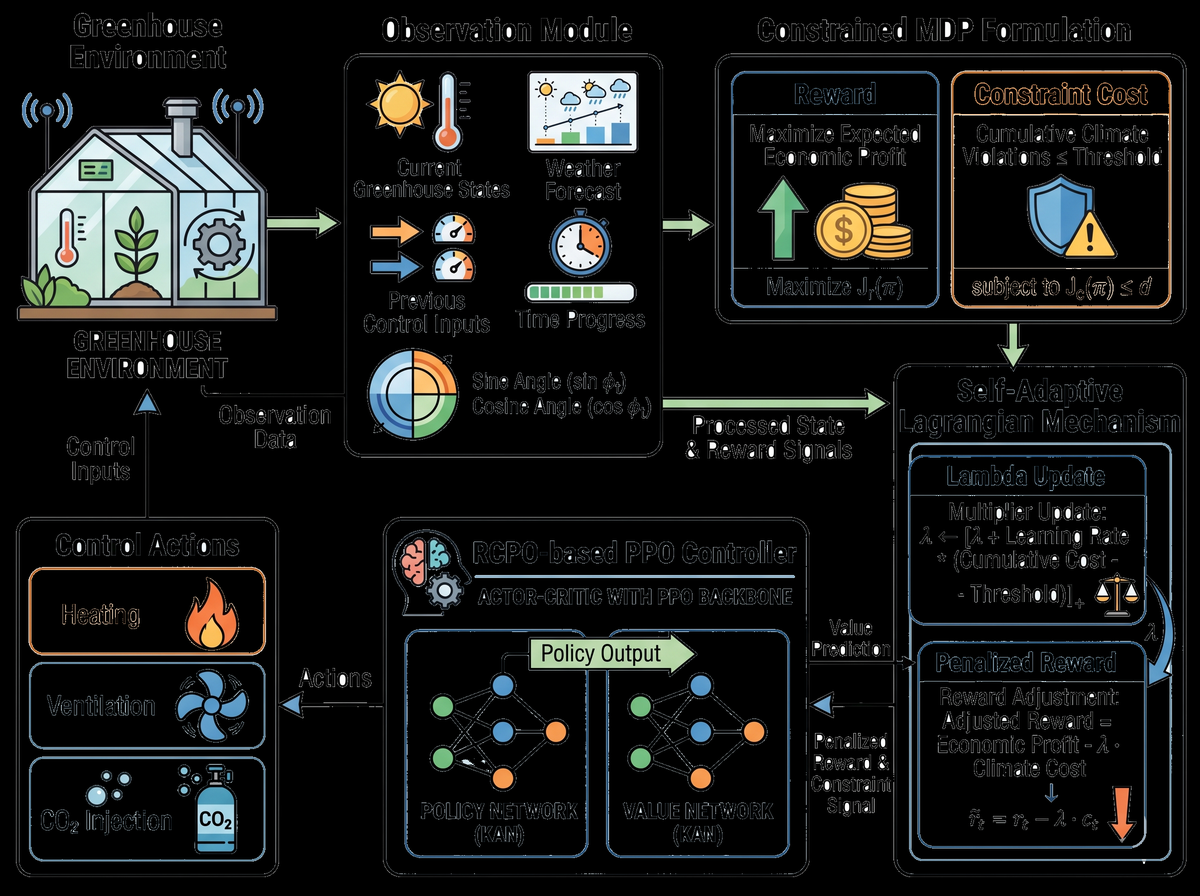
- 温室の気候制御をConstrained Markov Decision Processで定式化し、累積違反を明示的に制御する手法を提案
- 従来の報酬ペナルティに依存する手法とは異なり、Lagrangian法による適応型制約処理を導入
- Kolmogorov–Arnold Networksを用いたポリシー表現と周期的時間特徴の埋め込みにより、非線形性と時変性を効果的に捉える
論文の主張: 温室の気候制御において、経済的利益と長期的な安全リスクのバランスを取るため、Lagrangian-Constrained PPOとKANを用いた新しい制御手法を提案。従来手法と比較して、気候制約の累積違反を18.65%削減し、経済的利益を2.91%向上させた。
今回の論文は、温室の気候制御を安全に保つための新しい強化学習手法について述べています。特に、累積的な気候制約違反を制御するための制約付きマルコフ決定過程(CMDP)に基づいたアプローチが特徴的です。
なるほど、つまり長期的なリスクを明確に定義して管理するってことですね。特に、作物の健康や収益のバランスを取るという点が重要そうですね。
はい、その通りです。従来の手法では、報酬のペナルティで制約を扱うことが多いですが、これはパラメータ調整が難しいという問題がありました。この研究では、Lagrangian-Constrained PPOという手法を採用し、報酬と制約を分離して最適化することで、より柔軟に安全な制御が可能になっています。
それは面白いですね。それに、Kolmogorov–Arnold Networks(KAN)というネットワーク構造を使って、時間変化や非線形性を考慮しているんでしょうか。
はい、その通りです。KANは従来の多層パーセプトロン(MLP)に代わる構造で、非線形性の表現力が高く、特に時間的な周期性を捉えるのに効果的です。また、観測データに周期性を埋め込むためのsin/cosエンコーディングも導入されています。
なるほど、これで温度や湿度の変化のパターンをより適切に捉えられるんでしょうね。実験結果を見ると、従来のPPOに比べて制約違反が18.65%減少し、経済的利益が2.91%増加しているとされていますね。
はい、その通りです。特に、累積的な制約違反を抑えながら、作物の成長に適した環境を維持しつつ、経済的利益も最大化できるという点が評価されています。また、40日間の実天候データを用いたシミュレーションで検証されています。
40日間という期間は、季節的な変化も含まれるんでしょうか。それだと実際の運用に近い検証って言えるんでしょうか。
はい、その通りです。実際の温室では季節ごとの天候の変化が大きく影響するので、このシミュレーションは実用に近いものとなっています。また、冬のレタス栽培を対象としているため、寒冷期の運用にも適用可能です。
コスト面ではどうなんでしょう。この手法を導入するには、初期投資や技術の維持管理のコストがかかるんでしょうか。
研究では、具体的なコストデータは含まれていませんが、技術的には既存の強化学習の導入と似たような初期投資が想定されます。ただし、制御の精度が上がれば、加熱・冷却・CO2の管理コストも削減できる可能性があります。
なるほど、導入のメリットとリスクのバランスが大事そうですね。補助金の制度や、導入する温室の規模によって判断が分かれるんでしょうか。
はい、規模や地域、作物の種類によって導入の難易度や効果が変わる可能性はあります。また、導入する技術の信頼性や、運用のサポート体制も重要な要素です。
それと、今回の研究ではレタスが対象ですが、他の作物にも応用できるんでしょうか。
この手法は作物に依存せず、温室の制御問題を一般化したものなので、他の作物にも応用が可能です。ただし、それぞれの作物の成長特性や環境適応性を考慮する必要があります。
それなら、導入の幅が広がっていきそうですね。今後の展開も楽しみです。
はい、この研究は温室のスマート農業における新たな選択肢を示しており、今後の技術の進展とともに、実用化が期待できます。
背景と課題
温室では、温度、湿度、CO2濃度などの気候条件を作物の成長に適した範囲内で維持する必要がある。従来の強化学習手法は、報酬関数にペナルティを導入することで制約を強制していたが、これは長期的な違反を適切に抑制できず、作物の生育や病害に悪影響を及ぼす可能性があった。特に、固定されたペナルティ係数は過剰に保守的になるか、逆に安全を無視する結果を招く。
手法・アプローチ
本研究では、温室気候制御をConstrained Markov Decision Process(CMDP)として定式化し、経済的利益と気候制約の累積違反を分離して最適化する。Lagrangian-Constrained PPO(RCPO-PPO)を用いて、適応的な制約ペナルティを導入。また、Kolmogorov–Arnold Networks(KAN)をポリシーと価値関数の近似に用い、非線形性や時間変化を効果的に捉える。さらに、時間の周期性を考慮するためsin/cosエンコーディングを観測空間に組み込む。
実験結果
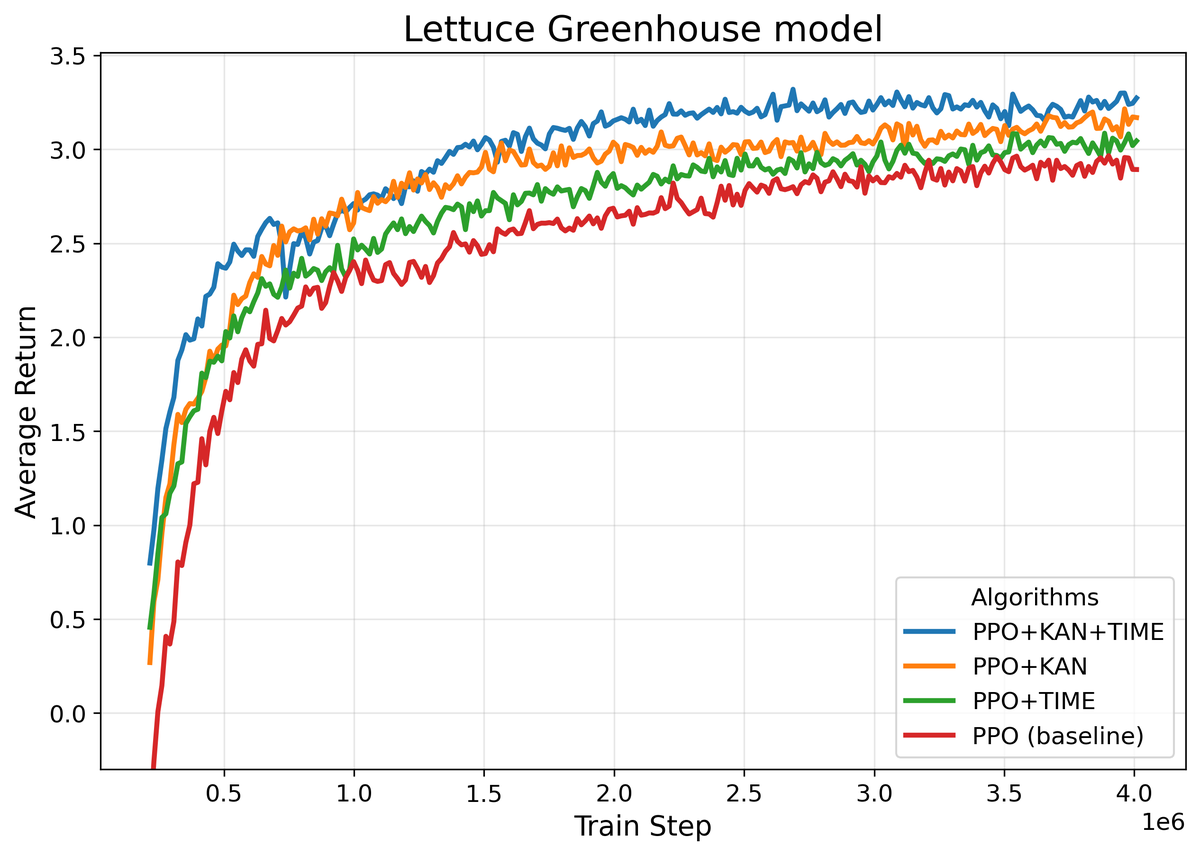
冬のレタスを対象とした40日間のシミュレーション実験で、提案手法は従来のPPOと比較して、気候制約の累積違反を18.65%削減し、総経済的利益を2.91%向上させた。また、制約違反を設定された安全閾値に近づけることが確認された。これは、従来の報酬ペナルティ方式では達成できなかった、長期的な安全制御の可能性を示している。
意義・応用可能性
本手法は、温室の長期的な気候リスクを制御しながら、経済的利益を最大化するための有効な手段を提供する。特に、作物の生育に敏感な環境制御において、安全かつ効率的な制御が可能となる。スマート農業の分野において、AIによる温室制御の精度と安全性の向上に寄与する。
限界と今後の課題
本研究は、シミュレーション環境での検証にとどまっている。実際の温室での適用には、モデルの不確実性や実機とのギャップの解消が必要である。また、KANの計算コストや、時間特徴の設計の最適化も今後の課題となる。
日本での適用可能性
日本では、温室農業が高度に発達しており、気候制御の精度と安全性が求められる。本手法は、特にレタスやトマトなどの葉物野菜の栽培に適用可能。農業現場での実装には、既存の温室制御システムとの統合や、リアルタイムデータの取得が重要となる。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: Safe Greenhouse Climate Control Using Lagrangian-Constrained PPO with Kolmogorov-Arnold Networks – 著者: Hangzun Liu, Yuling Fan, Fang Tian, Zhilong Bie, Zaiwen Feng, Yongliang Qiao – 発表日: 2026-09-28 – arXiv ID: 2609.34966v1 – カテゴリ: cs.AI