✨ 本論文の新規性
- 意味的一貫性に基づくクラスタリングで、検索結果のノイズを除去し、必要な知識量kを適応的に決定する仕組みを開発した。
- 検索した農業知識をLoRAパラメータに変換し、MLLMのFFN層へ注入することで、プロンプト連結より深い知識統合を実現した。
- 生成の不確実性に基づき、パラメータ推論と検索支援生成を切り替えるPPLガイド付きルーティング機構を導入した。
論文の主張: 既存のマルチモーダル検索拡張生成が抱える、検索ノイズと知識統合の浅さを解決するフレームワークAgri-MRAGを提案。パラメータレベルでの知識注入と不確実性ルーティングにより、農業視覚質問応答の精度と信頼性を向上させる。
今回取り上げるのは、農業視覚質問応答の精度を高める「Agri-MRAG」という研究です。従来の検索拡張生成が抱える、関連情報の取り込み不足や冗長性の問題を、パラメータレベルの知識注入で解決しようとするものです。
なるほど、画像から病害を診断するAIの話ですね。検索の精度と、その知識をどうAIに落とし込むかが課題だったと。特に面白いと感じたのはどの部分ですか。
興味深いのは、検索結果を単に文章として結合するのではなく、LoRAという軽量な適応パラメータに変換して、モデル内部に注入する手法です。これにより、推論時に外部知識をより自然に反映できる設計になっています。
パラメータ注入ですか。既存のモデルを再学習させる必要がないのは運用上有利ですが、複雑な処理に見えます。精度改善の具体的な数字は出ていますか。
はい、PlantVillageVQAというベンチマークで、ROUGE-Lスコアが41.21ポイントに向上しています。既存手法のmRAGより11.70ポイント、VisRAGより8.80ポイント高い結果です。
10ポイント以上の差は、実運用では大きいでしょう。ただ、この手法には「検索すべきか否か」の判断機能もあると聞きました。それはコスト削減に繋がりますか。
はい、パープレキシティに基づくルーティング機構を導入しています。モデルが確信を持てる場合は検索をスキップし、不確実な場合のみ外部知識を参照します。これにより、推論効率と回答信頼性のバランスを取っています。
賢い仕組みですね。検索サーバーへの負荷や通信コストを減らせるなら、大規模展開に向いているかもしれません。データセットの規模感はどうでしたか。
評価には、既存のPlantVillageVQAに加え、新たに作成したPlantVQAというデータセットを使っています。後者は林業や果樹作物に特化した、約7500枚の画像と1万5000組の質問応答ペアを含んでいます。
地域や作物に特化したデータを作るのは、汎用モデルが苦手な領域を補う上で重要ですね。ただし、こうした専門データの整備には、現場の協力とコストがかかります。
その通りです。研究者側がデータを集めるだけでなく、農業現場からのフィードバックをいかに取り込むかが、今後の展開を左右するでしょう。
技術的な進歩は着実ですが、農家が実際に使うツールとして普及するには、導入のハードルと費用対効果が問われますね。
ええ。この研究は診断支援の精度向上に貢献する可能性を示していますが、現場への実装には、地域ごとの病害状況や、既存システムとの連携といった課題が残ります。
メリットと課題の両面が見える内容でした。農業DXの一形態として、今後の動向を見守りたいですね。
背景と課題
スマート農業の普及に伴い、作物の病害診断や生育評価へのAI活用が進んでいる。しかし、汎用的なマルチモーダル大規模言語モデルは、農業特有の専門知識や視覚的に類似した症状の微細な違いを十分に学習していない場合がある。既存の検索拡張生成手法では、固定数の検索結果を用いるため、複雑な質問では情報が不足し、単純な質問ではノイズが増える傾向があった。また、検索した知識をテキストとしてプロンプトに連結する方式では、モデル内部の表現との結合が弱く、長文コンテキストによる注意散漫が生じやすいという課題が残されていた。
手法・アプローチ
提案手法Agri-MRAGは、3つの主要コンポーネントで構成される。まず、検索候補をマルチモーダル埋め込み空間で階層クラスタリングし、意味的一貫性の高いサブセットを選択する。これにより、検索サイズkをクエリに応じて適応的に決定し、ノイズを抑制する。次に、選択された知識をLoRAアダプタへエンコードし、MLLMのフィードフォワードネットワーク層へ動的に注入する。このパラメータレベルの知識注入により、外部知識をモデル内部へ深く統合する。さらに、生成時のパープレキシティに基づき、確信度が高い場合はパラメータ推論のみを使用し、不確実性が高い場合は検索支援生成へ切り替えるルーティング機構を採用する。
実験結果
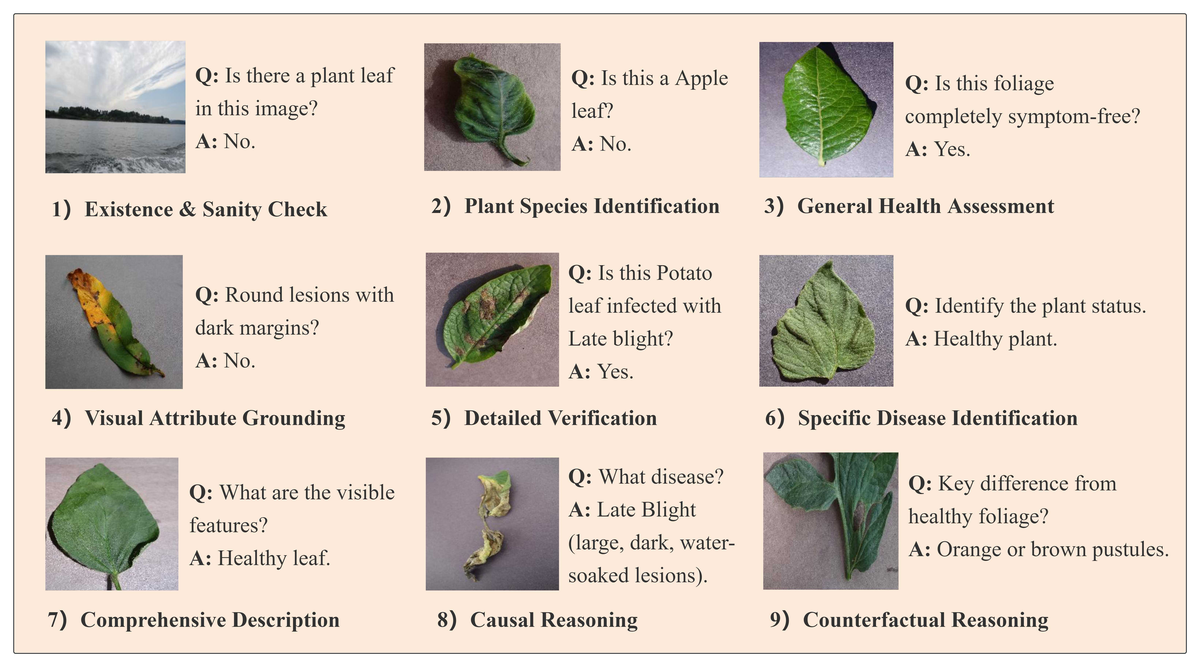
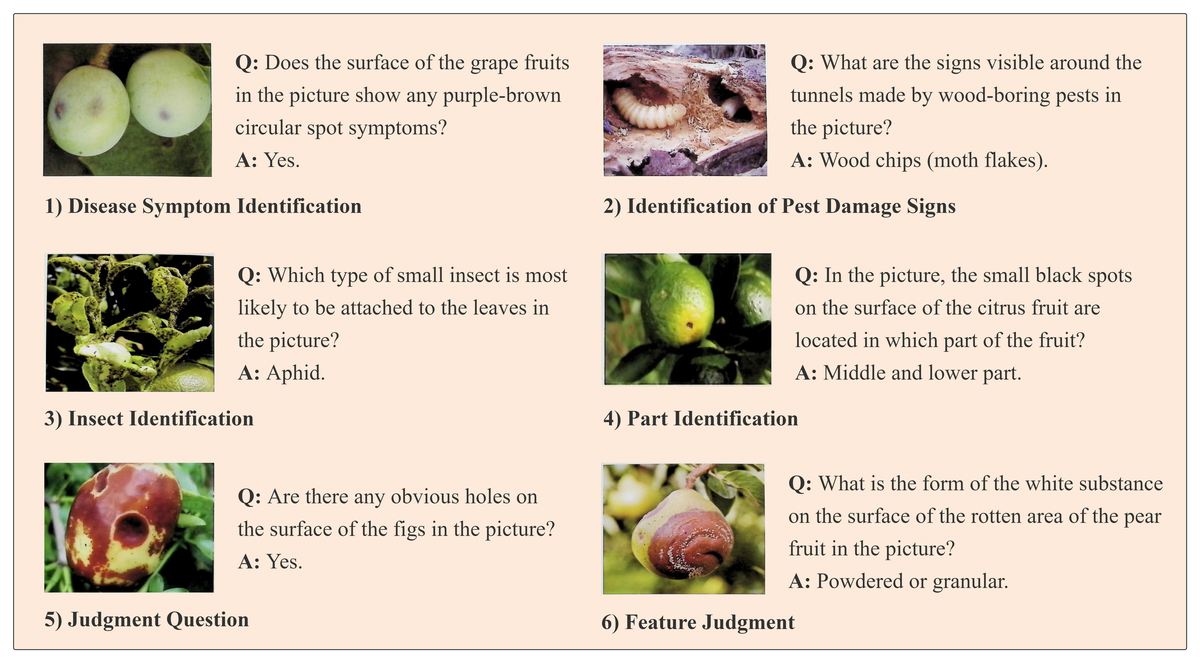
評価には、広範な農業データセットPlantVillageVQAと、本研究で構築した地域特化型データセットPlantVQAを使用する。PlantVQAは、新疆ウイグル自治区の主要経済作物であるナツメ、香梨、リンゴ、柑橘類、ブドウの病害虫に関する7,514枚の画像と15,028件の専門家検証済みQAペアを含む。実験結果では、Agri-MRAGはPlantVillageVQAでROUGE-Lスコア41.21、PlantVQAで46.58を記録した。これは既存のmRAGベースラインに対し、それぞれ11.70ポイントと4.51ポイントの向上を示している。また、VisRAGベースラインに対しても、それぞれ8.80ポイントと3.39ポイント上回った。
意義・応用可能性
本手法は、農業現場での病害診断支援において、AIの回答精度と信頼性を高める可能性がある。特に、視覚的に類似した症状を持つ病害の区別や、地域特有の病害知識を必要とする場面で有効である。パラメータレベルでの知識注入により、モデルが外部知識をより深く理解し、一貫性のある回答を生成できる。また、不確実性ルーティングにより、計算コストと回答品質のバランスを最適化できるため、リソースが限られる現場での展開にも適している。
限界と今後の課題
本研究では、PlantVQAデータセットの画像がWebクロール由来であり、統一されたライセンス体系を持たない点が制約として挙げられる。また、LoRAアダプタのオフライン学習には、各知識サンプルに対する再サンプリングと学習が必要であり、知識ベースが大幅に更新される場合の再学習コストが課題となる。さらに、PPL閾値の設定は経験的に決定されており、異なる農業環境や作物種への汎用性を確保するためには、より厳密な理論的根拠に基づく調整が求められる。
日本での適用可能性
日本では、リンゴ、ブドウ、ミカンなどの果樹栽培が盛んであり、地域ごとの病害対策が重要である。Agri-MRAGの地域特化型知識注入手法は、日本の果樹園における病害虫診断支援システムに応用可能である。特に、視覚的に判別が難しい初期症状の検出や、複雑な病害複合症状の解析において、専門家レベルの知識をAIへ統合することで、生産者の判断を支援できる。また、LoRAによる軽量なパラメータ更新は、既存の農業IoTシステムへの統合が比較的容易である。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: Agri-MRAG: Parameter-Enhanced Multimodal Retrieval-Augmented Generation for Agricultural Visual Question Answering – 著者: Fuyong Liu, Xiantao Lei, Xining Zhang – 発表日: 2026-11-12 – arXiv ID: 2611.18771v1 – カテゴリ: cs.CV