農業画像理解の新たな基準:ピクセルレベルのマルチモーダルモデルAgriScope
📄 論文サマリー
著者:Abderrahmene Boudiaf、Mohamad Alanssari、Irfan Hussain、Sajid Javed
発表:arXiv(コンピュータビジョン)/2609.20325v1
公開日:2026年09月17日
✨ 本論文の新規性
- ピクセルレベルの視覚的接地を可能にするマルチモーダルモデルAgriScopeを提案
- 農業専門の視覚・語彙表現と空間的マッピングを統合した新しいエンコーディング方式を導入
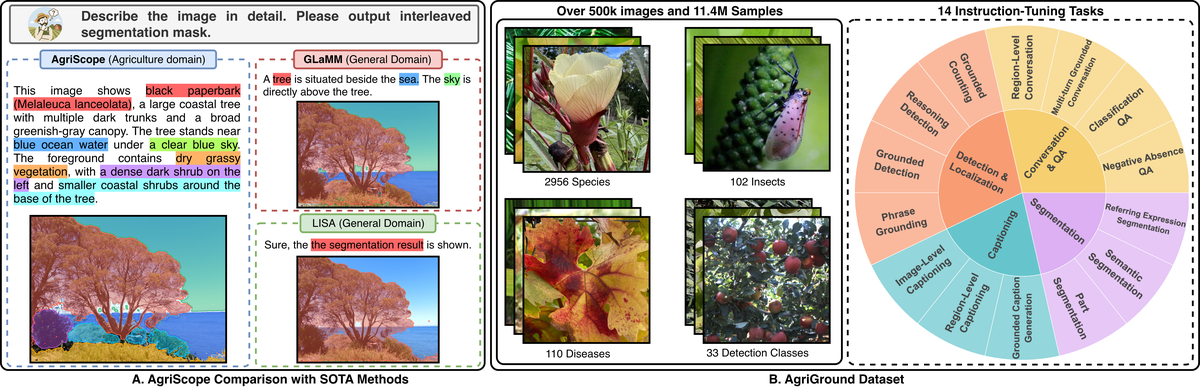
- 50万枚以上の画像と1100万件の指令サンプルを含む大規模データセットAgriGroundを構築
論文の主張: 農業画像における病害、害虫、作物の識別と位置特定を同時に行うピクセルレベルのマルチモーダルモデルAgriScopeと、その学習用データセットAgriGroundを紹介。従来のテキストベースモデルとは異なり、画像内での具体的な領域を示すセグメンテーションマスクを生成可能。
今回の話題は、arXivに投稿された論文「AgriScope: Pixel-Grounded Multimodal Understanding for Agricultural Images」です。農業画像の理解を深めるための新しいマルチモーダルモデルと、それにマッチする大規模データセットの開発について述べています。
なるほど、画像をもとに病害や害虫を細かく識別できる技術ですね。特に「ピクセルグランド」の部分が気になる所です。
はい、AgriScopeは、画像レベル、領域レベル、ピクセルレベルでの理解を同時に可能にする統一フレームワークです。つまり、植物の病気や害虫がどの部分に影響しているかを、画像内のどこに該当するかを正確に示せるんです。
それは重要な特徴ですね。現状のモデルだと、病気を言葉で説明するしかできなかったそうですが、これで具体的な場所も特定できるんですか?
その通りです。従来モデルは、テキストの出力しかできず、画像内での位置を示すことができませんでした。AgriScopeでは、生物の専門知識を統合しながら、空間的に正確にマッピングしています。
50万枚以上の画像を含むデータセットですね。その規模って、実運用にどれくらいの影響を与えるんでしょうか。
AgriGroundというデータセットは、50万枚以上の画像と1100万件のinstruction-followingサンプルを含んでいます。これにより、細かな病害分析から害虫の識別まで、多様な農業タスクを効果的に学習できます。
それは規模的にもインパクトありますね。ただ、データの品質管理って大変そうですね。自動アノテーションのプロセスをどうやって実現したんでしょうか。
多段階の自動アノテーションパイプラインを構築しています。例えば、マルチモーダルキャプション生成、語彙レベルの位置づけ、セグメンテーションマスクの生成といった工程を連携させています。
コストと時間の面で、この自動化は大きなメリットになるんでしょうね。実際の農家が利用するには、導入が難しい部分もあるかもしれませんね。
それはごもっともです。特に初期の導入コストや、技術的なサポートが必要になる点は課題です。ただし、補助金制度の活用や、IoT機器との連携が進むことで、実用化の可能性は広がってきています。
そうですね。農業の自動化は補助金に強く依存しますから、政策の変化にも注意が必要です。この研究は、技術面では非常に前進していますが、実際の現場での導入は慎重に見極める必要があります。
はい。AgriScopeは、画像理解の精度だけでなく、マルチモーダルでグランドされたデータを活かすことで、農業の意思決定支援にも役立つ可能性を秘めています。
それだけの価値がある研究ですね。今後の展開も楽しみです。
背景と課題
農業におけるコンピュータビジョン技術は、病害診断や作物分類、害虫検出などに利用されており、精度向上が求められている。しかし、従来のモデルは主にテキスト出力のみであり、画像内の特定領域の位置を示すピクセルレベルの視覚的接地が不十分である。特に、農業画像は環境変化や被写体の多様性により、一般的な画像認識と大きく異なる課題を抱えている。
手法・アプローチ
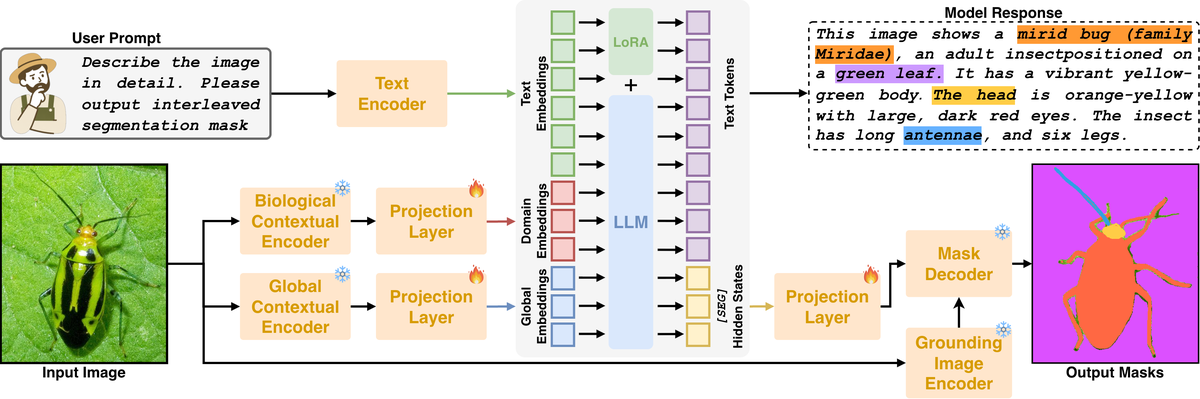
提案モデルAgriScopeは、生物的意味表現と空間的特徴を統合するマルチモーダルフレームワーク。BioCLIP2による生物的セマンティックエンコーディング、DINOv3によるグローバル空間表現、SAM2によるピクセルレベルセグメンテーションを組み合わせた。自然言語プロンプトに応じて、画像全体から領域、ピクセルレベルまでを理解し、セグメンテーションマスクを出力する。
実験結果
AgriScopeは、農業画像理解タスクにおいて従来のモデルを上回る性能を示した。特に、画像レベル、領域レベル、ピクセルレベルのマルチモーダル理解を統合した評価で、病害診断や作物分類の精度が向上。AgriGroundデータセットを用いた学習により、1100万件の指令サンプルを活用したマルチモーダル学習が可能になった。
意義・応用可能性
AgriScopeは、農業現場での意思決定支援に直接活用可能。例えば、病気の発生部位を明確に示すことで、農家が適切な薬剤散布や管理行動を取れる。また、ロボット農業やスマートファーミングへの応用も期待され、AIによる農業の自動化・効率化に貢献する。
限界と今後の課題
提案モデルは、大量のラベル付きデータを必要とするため、実際の現場での適用には課題がある。また、画像の品質や環境条件の変化にさらに対応するための拡張性も今後の課題である。さらに、マルチモーダルな理解を深めるためには、より豊かな語彙や知識ベースとの連携が求められる。
日本での適用可能性
日本の農業現場では、病害診断や害虫管理の自動化が求められている。AgriScopeは、特に病気の早期発見や正確な位置特定が可能であり、スマート農業の推進に貢献できる。また、農業用ロボットとの連携も視野に入れて、現場での導入が期待できる。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: AgriScope: Pixel-Grounded Multimodal Understanding for Agricultural Images – 著者: Abderrahmene Boudiaf, Mohamad Alanssari, Irfan Hussain, Sajid Javed – 発表日: 2026-09-17 – arXiv ID: 2609.20325v1 – カテゴリ: cs.CV