📄 論文サマリー
著者:Hicham El Akhal、Abderrahim Waga、Aissa Ben Yahya、Abdelbaki El Belrhiti El Alaoui
発表:arXiv(人工知能)/2610.35984v1
公開日:2026年10月26日
✨ 本論文の新規性
- 従来の単純な画像変換に加え、DCGANによる合成画像生成とCutMix、MixUpを組み合わせたハイブリッドなデータ生成フレームワークを提案した。
- クラス不均衡の解消、データ量増加、両者の同時実現という3つの異なるデータ分布シナリオを設定し、各手法の効果を体系的に比較評価した。
- オリーブ葉の6つの病害と健全葉を含む多クラス分類において、特に少数クラスの検出精度向上に寄与するデータ生成戦略の有効性を示した。
論文の主張: オリーブ病害分類におけるデータ不足と不均衡に対し、DCGANやCutMix等の高度な生成手法を組み合わせ、3つのデータ分布シナリオで検証した。バランス調整とデータ増強の組み合わせにより、モデルの汎化性能と精度を向上させた。
今回紹介するのは、モロッコの大学群による研究で、オリーブの病害分類における深層学習モデルの性能向上に関する論文です。データ不足やクラス不均衡という課題に対し、従来の拡張手法に加え、ディープコンボリューション生成敵対的ネットワークなどを用いたデータ生成戦略を提案しています。
データ不足は農業AI導入の大きな壁ですね。特にオリーブのような特定作物では、病害の画像収集自体がコストになりそうです。この研究で一番のポイントはどこですか?
生成したデータを「クラス分布のバランス化」「サンプル数の増加」「バランスを保ちつつ拡張」という3つのシナリオで評価している点です。エフィシェントネットV2B0というモデルで検証し、データの多様性とクラスバランスが分類精度に大きく影響することを実証しています。
なるほど、単にデータを増やすだけでなく、使い方を工夫しているわけですね。実運用では、この手法のコストパフォーマンスはどう見られますか?
研究では、既存の限られたデータセットから新たにサンプルを作成するため、実地での追加撮影コストを抑えられる可能性があります。一方で、生成データの品質管理や、モデルへの適用には高度な技術的知識が必要となります。
技術的なハードルは高そうです。オリーブは地域によって生育条件が異なりますから、生成データが現地の気候や病害パターンと合致するかも気になります。
そこが課題ですね。論文では特定の環境下での有効性を示していますが、異なる地域への適用には再学習が必要になるでしょう。データ生成戦略は万能ではなく、適用範囲を慎重に判断する必要があります。
既存の診断システムに組み込む場合、既存データとの整合性をどう保つかが鍵になりそうです。追加投資に見合うリターンがあるか、慎重に検討すべきですね。
ええ。データ生成は精度向上に寄与しますが、運用コストや維持管理の複雑さを増す側面もあります。メリットと課題を天秤にかけ、導入の可否を判断することになります。
データ不足を解決する一つの選択肢としては興味深いですね。技術の成熟度と実地での検証結果を待ちたいところです。
背景と課題
オリーブ栽培における病害は収量低下の主因であり、早期発見が重要だ。しかし、従来の目視検査は熟練者の負担が大きく、専門家が不足する地域では診断遅延が生じやすい。AIによる自動診断は有望だが、学習データの不足や特定病害のサンプル数偏り(クラス不均衡)がモデルの精度を制限する要因となってきた。本研究は、こうしたデータ品質の問題を生成技術で解決し、実運用可能な診断モデルの構築を目指す。
手法・アプローチ
研究チームは、モロッコのオリーブ農園等で収集した6170枚の画像データを使用し、EfficientNetV2B0を基盤モデルとして採用した。データ生成には、回転や反転などの従来型拡張に加え、画像の一部を切り替えるCutMix、線形補間を行うMixUp、そして敵対的生成ネットワークであるDCGANを用いた。生成されたデータを用いて、1.クラスバランスの調整、2.各クラスサンプル数の増加、3.バランス調整と増加の同時実施、という3つのシナリオ(S1〜S3)を設計し、モデルの学習に適用した。
実験結果
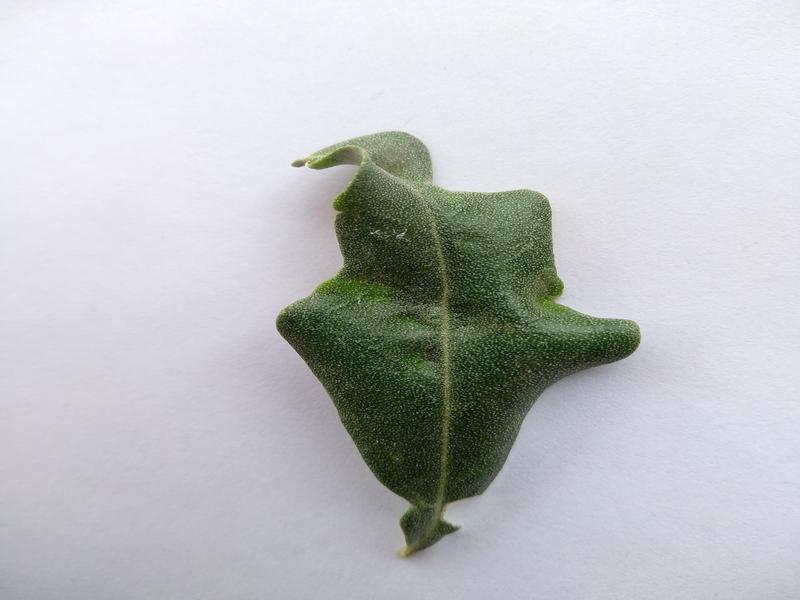
拡張なしのベースライン精度は90.99%だった。クラスバランスを整えたシナリオS1では、全手法を組み合わせた場合で93.09%(+2.10ポイント)と最も高い精度を記録した。特にDCGAN単体でもF1スコアが93.14%に向上し、合成画像の有効性が示唆された。データ量を増やしたシナリオS2では、MixUpが単体で最も安定した改善を見せ、組み合わせ手法で精度95.99%を達成した。一方、バランスと増加を同時に行ったシナリオS3では、CutMixがF1スコア92.28%で最良となり、手法の組み合わせによっては効果が飽和する傾向も確認された。
意義・応用可能性
本研究は、単なる画像変換ではなく、生成AIを組み合わせたデータ拡張戦略が、特に少数クラスの病害検出においてモデルの頑健性を高めることを実証した。オリーブ以外の作物でも、病害サンプルが希少な状況下でのAI導入に活用できる。データ分布のシナリオ別評価により、現場のデータ状況に応じた最適な生成手法の選択基準を提供する。
限界と今後の課題
DCGANによる画像生成には約3ヶ月、品質選別にも2ヶ月を要し、計算コストと時間的制約が大きい。また、シナリオS3では複数の手法を併用した際に精度向上が頭打ちになる「飽和」現象が見られ、手法間の相乗効果の最大化にはさらなる検討が必要だ。実環境での多様な撮影条件への適応性や、異なるオリーブ品種間での汎用性についても、今後の検証が求められる。
日本での適用可能性
日本ではオリーブ栽培が香川県や小豆島などで拡大しており、同様の病害管理課題が存在する。本研究の手法は、国内の農業試験場やスタートアップが保有する限られた病害画像データセットの質を高めるために応用可能だ。特に、発生頻度の低い病害の学習データを補完する際、DCGAN等の生成技術を活用することで、診断システムの開発期間短縮と精度向上が期待される。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: Enhancing Deep Learning Model Performance through Data Generation Strategies: Classification of Olive Tree Diseases – 著者: Hicham El Akhal, Abderrahim Waga, Aissa Ben Yahya, Abdelbaki El Belrhiti El Alaoui – 発表日: 2026-10-26 – arXiv ID: 2610.35984v1 – カテゴリ: cs.AI