📄 論文サマリー
著者:Akram Zaytar、Kemunto Ochwang’i、Caleb Robinson 他5名
発表:arXiv(機械学習)/2611.00794v1
公開日:2026年10月31日
✨ 本論文の新規性
- 道路沿いや平坦地などアクセスしやすい場所のみで収集されたラベルによる評価の偏り(デプロイメント性能ギャップ)を、最大0.20 macro-F1まで定量化した
- Prediction-powered inference (PPI) を作物分類に適用し、衛星埋め込み特徴量を用いた重み付けにより、従来の交差検証では過大評価される実運用精度を誤差0.07以内に修正した
- 欧州5地域でのシミュレーションとケニア3データセットへの適用により、道路沿いデータセットで評価値が0.93から0.61へ大幅に低下する事例を実証した
論文の主張: 政府機関が利用する作物マップは、道路沿いなど収集しやすい場所のデータで評価されがちで、実運用時の精度を過大評価する傾向がある。本研究は、未ラベルデータの予測とラベルデータの誤差を重み付けして補正するPPI手法を用い、この評価バイアスを修正し、実運用に近い精度推定を可能にした。
今回紹介するのは、マイクロソフトの研究所による論文で、農作物マップの評価精度における「サンプリングバイアス」の問題を扱っています。政府機関などが食料安全保障のために使う作物地図ですが、検証用の現場データは、アクセスしやすい道路沿いばかりで集められていることが多いんですよね。その結果、道路から離れた場所での精度が実際より高く見積もられている、という指摘です。
なるほど、現場の都合でデータが集まる場所が偏るわけですね。それは確かにありそうな話です。特に印象に残ったポイントはどこですか。
「展開性能ギャップ」と呼ばれる現象です。検証データが道路沿いだけだと、モデルはそこでの精度しか測れません。しかし実際の運用地域全体では、モデルが誤判する場所が別にあるんです。この差が、最大で0.20のマクロF1スコアとして現れることが、シミュレーションで示されています。
0.20の差は、数字としてはかなり大きいですね。既存の交差検証では、このギャップを埋められないということでしょうか。
そうです。従来のブロック交差検証でも、最大0.18程度、精度を過大評価していました。そこで提案されているのが、PPIという手法です。衛星画像の特徴量を使って、サンプルされていない場所での誤りを推定し、重み付けして修正します。これにより、最大誤差を0.07まで抑えることができました。
衛星画像のデータを活用して補正するのか。技術的には面白いですね。ただ、この修正がどの程度信頼できるのか、ビジネスの現場では気になるところです。
そこが重要な点で、論文ではケニアの3つのデータセットで検証しています。特にヘルメットカメラで撮影された道路沿いのデータでは、ランダムな交差検証だと0.93だった精度が、PPIによる修正後は0.61まで下がりました。この大きな差こそが、従来の評価方法の問題点を象徴しています。
0.93から0.61へ。実運用時のリスクを考えると、これは衝撃的な下落ですね。修正後の数値を信じるべきか、元の数値をどう扱うべきか、判断が難しいところです。
はい。論文では、修正の信頼性を示すため、有効サンプル数も報告しています。特定のラベルに重みがかかる場合、少数のデータに依存している可能性があります。ですので、この手法は万能な解決策というよりも、バイアスの存在を可視化し、より慎重な判断材料を提供するものとして捉えるべきでしょう。
つまり、精度の絶対値よりも、その評価がどの程度偏っているかを知るためのツールだと。補助金申請や政策決定の文脈では、データの透明性が求められる機会も増えていますから、こうした検証手法の普及は意味がありそうです。
ええ。既存の現場ラベルを、地域全体の推定値に変換するためのツールキットも公開されています。農業分野に限らず、地理空間データの活用において、サンプリングの偏りをどう扱うかは、今後の重要な課題と言えますね。
データ活用の基礎的な議論として、広く応用されそうですね。メリットと課題の両面があるテーマですが、今後の動向が注目されます。今日はここまでです。
背景と課題:道路沿いデータによる評価の過大評価
政府機関は食料安全保障や農業政策のために衛星由来の作物マップを利用している。これらのマップは現場のラベルデータで検証されるが、収集チームは道路沿いやアクセスしやすい場所を優先し、小規模な区画や険しい地形をスキップする傾向がある。このため、検証データはマップ全体を代表しない偏ったサンプルとなる。本研究は、この偏ったデータで算出される評価値と、マップ全体での実際の性能との差を「デプロイメント性能ギャップ」と定義し、その修正手法を提案する。
手法:Prediction-powered inference (PPI) の適用
提案手法はPrediction-powered inference (PPI) をベースとする。まず、マップ全域の未ラベルデータに対する分類器の予測から初期推定を行う。次に、ラベル付きデータにおける分類器の誤差を計算し、収集されにくい条件のラベルに大きな重みを付与して初期推定を補正する。重み付けには、ラベル付きデータと未ラベルデータを区別するPropensityモデルを用いる。本研究では、AlphaEarth衛星埋め込み特徴量や収集ルールの共変量をPropensityモデルの特徴量として比較検討した。
実験結果:欧州5地域でのシミュレーション評価
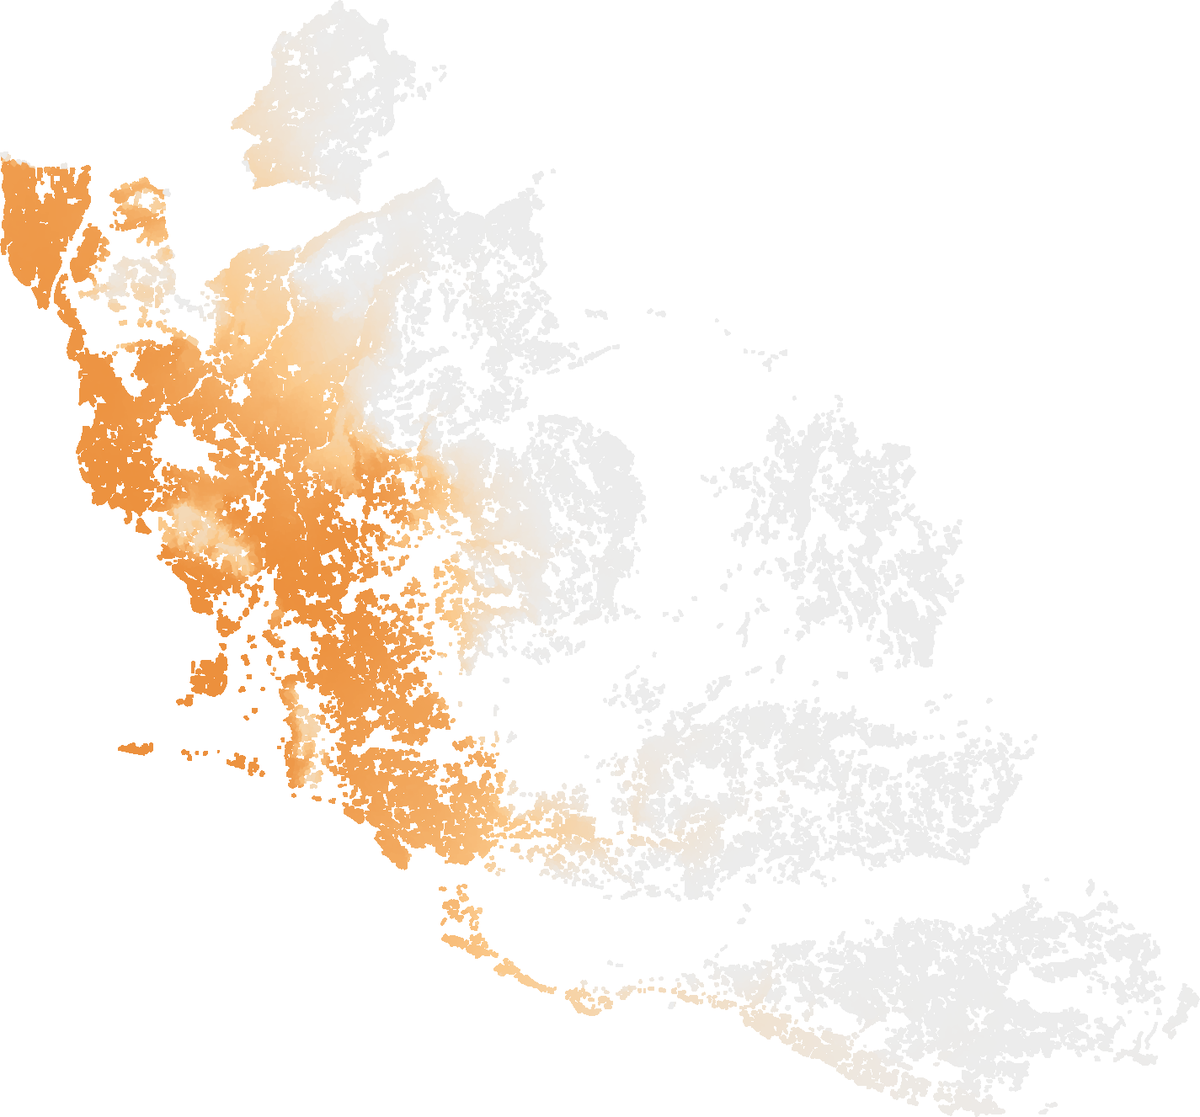
欧州5地域で、道路距離や標高、区画サイズなど6つの収集ルールをシミュレーションした。その結果、従来のランダム交差検証では最大0.20 macro-F1の過大評価が発生した。特に「小規模区画除外」や「標高制限」などのルールでギャップが大きい。PPI手法を適用すると、最悪ケースでの平均誤差を0.18から0.07へ低減できた。また、同じ重みを用いた重要度重み付き交差検証 (IWCV) も同程度の精度を示し、改善の多くは重み付け自体に起因することが分かった。
意義と応用:ケニアでの実データ検証
基準ラベルがないケニアの3データセットで手法を検証した。ヘルメット装着カメラで道路沿いに収集された「Helmets」データセットでは、ランダム交差検証での評価値0.93に対し、PPIによる推定値は0.61まで低下した。これは、道路沿いデータが樹木被覆などマップ全体の多様性を反映していないためである。この手法により、限られた予算とアクセス条件下で収集されたデータから、より信頼性の高い実運用精度を推定できる。
限界と今後の課題
PPIの精度は、Propensityモデルの推定品質に依存する。収集ルールが不明な場合、埋め込み特徴量に基づく重み付けは有効だが、モデルの誤指定が残る可能性がある。また、重み付けが少数のラベルに集中すると、有効サンプルサイズが低下し、推定の信頼性が損なわれる。ケニアの例では、補正が少数の重み付きラベルに依存しており、この点に注意が必要である。
日本での適用可能性
日本では農林水産省の圃場マップや、ドローン・衛星による営農支援サービスが普及しつつある。しかし、検証データは圃場へのアクセス性や農家の協力関係に偏りやすい。本手法を導入することで、限られた現地検証データから、全国規模の作物分類精度をより正確に推定できる。これにより、食料生産量の予測や災害時の被害推定における信頼性が向上する可能性がある。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: Crop Mapping Evaluation under Sampling Bias – 著者: Akram Zaytar, Kemunto Ochwang’i, Caleb Robinson, Girmaw A. Tadesse, Gilles Q. Hacheme, Rahul Dodhia, Inbal Becker-Reshef, Juan M. Lavista Ferres – 発表日: 2026-10-31 – arXiv ID: 2611.00794v1 – カテゴリ: cs.LG