📄 論文サマリー
著者:Khush Kataruka、Mohammad Muzammila、Zahid Akhtar、Raghavendra Ramachandra、Praveen Kumar Chandaliya
発表:arXiv(コンピュータビジョン)/2610.29008v1
公開日:2026年10月21日
✨ 本論文の新規性
- 未見の品質等級に対する汎用性を評価する「Leave-One-Grade-Out」プロトコルを初めて導入し、実運用に近い検証環境を構築した。
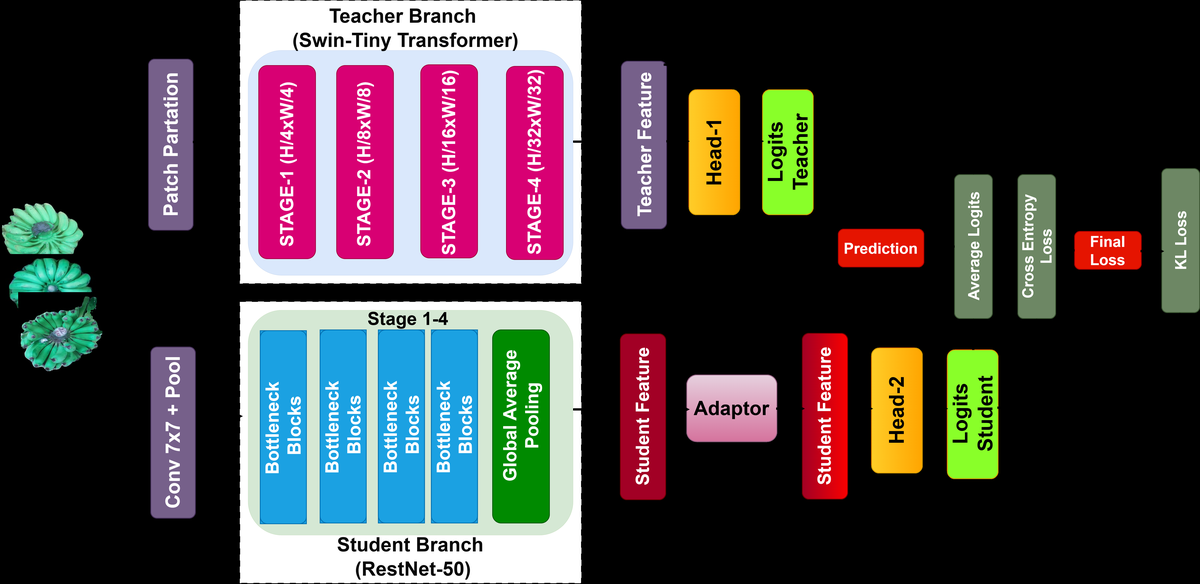
- Swin TransformerとResNet50を並列処理するデュアルストリーム構造を提案し、KLダイバージェンスによる自己蒸留で特徴表現を整合させた。
- 単一モデルでは困難な等級間ドメインシフトを抑制し、平均精度81.25%を達成して従来のCNNやTransformer単体モデルを上回った。
論文の主張: バナナの品種分類において、学習時に含まれない品質等級への汎用性が課題だった。本研究はSwin TransformerとResNetを組み合わせ、KLダイバージェンスによる自己蒸留を導入。これにより等級間の外観変化に強い特徴表現を獲得し、平均精度81.25%を実現した。
今回紹介するのは、バナナの品種と品質等級を自動で分類する技術に関する研究論文です。インドの国立工科大学などが中心となり、CNNとTransformerを組み合わせたハイブリッドモデルで、未知の品質等級への汎用性を高める手法を提案しています。
なるほど、画像認識の分野ですね。農業での品質管理は目視検査が主流なので、自動化の期待は大きいですが、特に印象に残ったポイントはどこでしたか。
「Leave-One-Grade-Out」と呼ばれる評価手法が特徴的です。ある品質等級のデータで学習し、見えていない等級でテストするという、過酷な条件で性能を測っています。これは実際の出荷現場で、季節や産地による変化に耐えられるかを見るためですね。
見えていない状態での精度を重視するんですね。既存の検品システムは、学習データと違う光環境や熟度になると誤作動しやすいと聞きますから、この厳しさは実運用向きと言えそうです。
そうなんです。データセットは3万1千枚以上の画像を使い、3品種と3つの品質等級を扱っています。結果として、提案されたハイブリッドモデルは平均精度81.25%を記録し、従来の単独モデルを上回りました。
8割超えですね。数字としては実用ラインに近いですが、誤差が19%あるわけです。選別ラインで19%の誤りが発生すると、クレーム対応や再選別のコストが気になりますね。
ここが難しいところで、研究では「知識自己蒸留」という技術を使い、CNNとTransformerの両方の強みを統合しています。局所的な質感と全体的な構造を同時に捉えることで、劣化した画像や見慣れない等級でも安定した判断ができるようになっています。
技術的には面白いですね。ただ、導入コストはどうでしょうか。高精細カメラと高性能な処理装置が必要になると、小規模なパックハウスでは投資回収に時間がかかりそうです。
そこが課題ですね。論文ではハードウェアコストの詳細は扱われていませんが、Transformerは計算量が多いため、リアルタイム処理には高性能なGPUが必要になる可能性が高いです。大規模な輸出拠点など、処理量が膨大な場所でなければ、採算が合わないかもしれません。
やっぱり規模感が鍵になりそうです。人手で目視検品する場合の労務コストと、システム導入後の維持費を比較しないことには、導入判断は難しいですね。
ええ、その通りです。研究の目的は、ドメインシフト、つまり環境変化による精度低下を抑えることです。これにより、一度システムを導入しても、産地が変わったり季節が変わったりした際に、再学習の手間を減らせる可能性があります。
再学習の手間が下がるのは大きいですね。農業は天候に左右されますから、毎年モデルを作り直すのは現実的ではありません。安定した運用が見込めるなら、初期投資を正当化する理由にはなり得ます。
一方で、この技術がすべての農家に向いているわけではありません。データ収集の質や、既存の選別ラインとの連携など、実装には多くの調整が必要です。あくまで、高精度な自動選別を求める大規模ビジネス向けの選択肢の一つと言えますね。
メリットと課題が明確ですね。技術の成熟度と現場のニーズがどこで交差するか、今後の導入事例を見てみたいところです。今日はここまでです。
背景と課題
バナナは世界で年間1億1400万トン生産される主要作物だが、収穫後の品質管理は人手に依存している。機械選別機は表面の傷や変色を十分に検出できず、接触による二次損傷も懸念される。既存のAI分類モデルは特定の品質等級のデータで学習すると、別の等級では精度が低下する「ドメインシフト」に弱い。成熟度や外観の差異が大きい等級間での安定した判別が求められていた。
手法・アプローチ
本研究は、グローバルな文脈を捉えるSwin Transformerと局所的な質感を抽出するResNet50を並列に動作させるハイブリッド構造を採用した。両者の出力を融合させる際、KLダイバージェンスを用いた自己蒸留を適用する。Transformer側を教師、CNN側を生徒とみなし、確率分布の整合性を図ることで、等級に依存しない不変な特徴表現を学習させる。これにより、単一アーキテクチャの弱点を補完し、ドメイン変化への耐性を高める。
実験結果
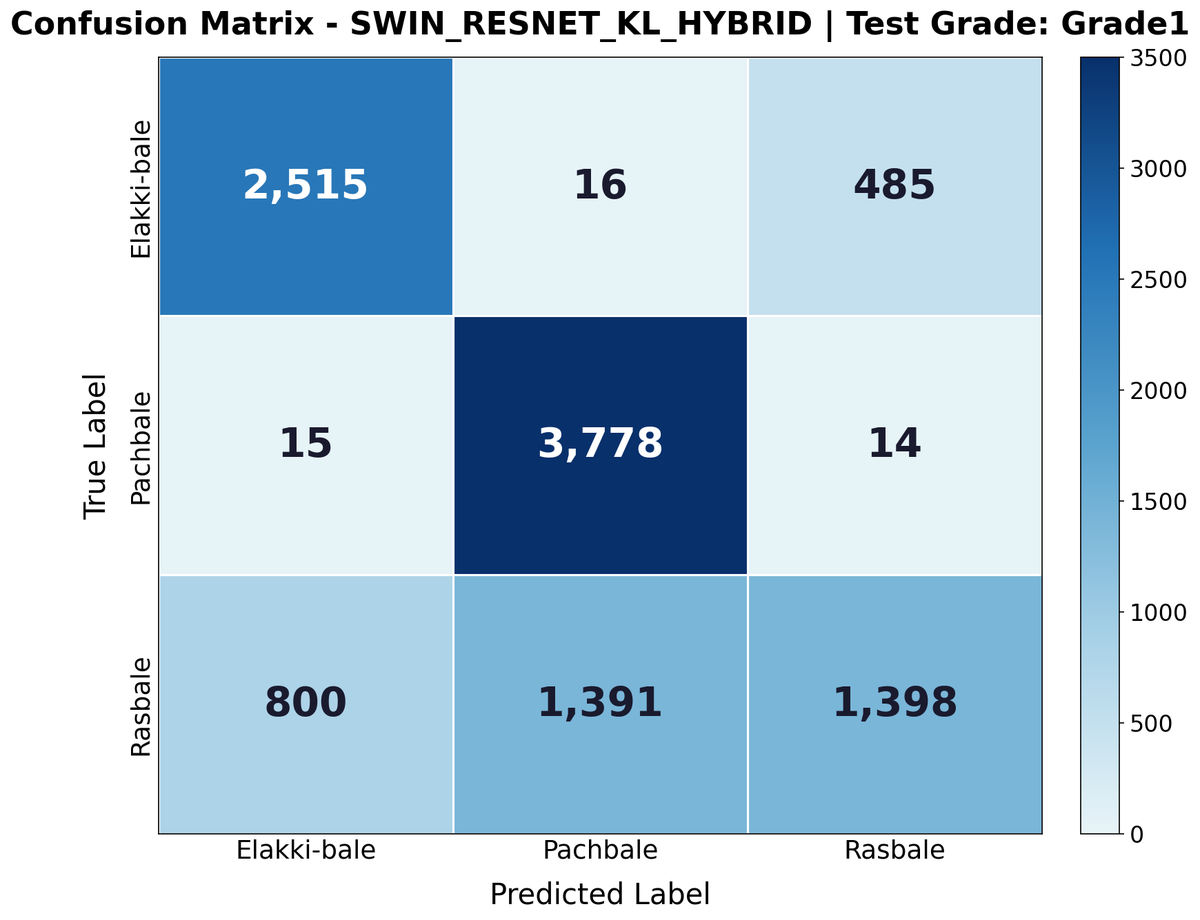
3品種・3等級からなる3万1678枚の画像データセットを使用し、1つの等級をテスト用に除外するLOGO方式で評価した。提案手法は平均精度81.25%を記録し、ResNet50やSwin Transformer単体モデルを有意に上回った。特に、外観のばらつきが大きい等級1や、視覚的に一貫性のある等級3においても安定した性能を示した。Grad-CAMによる可視化では、等級変化に影響されにくい部位に注意が集中し、特徴転移の改善が確認された。
意義・応用可能性
この手法は、学習データに含まれない未知の品質状態に対してもロバストな分類を可能にする。選別ラインでの等級混在や、季節による外観変化に対応するシステムの実現に寄与する。知識蒸留を用いた軽量・高速化の余地があり、エッジデバイスでの実装も視野に入る。農産物の流通における品質保証の自動化を推進し、人的検査の負担軽減と経済損失の削減に貢献する。
限界と今後の課題
平均精度81.25%は実用レベルだが、誤分類が許されない高付加価値市場ではさらなる高精度化が必要である。本研究は南アジアの3品種に限定されており、他地域や品種への転用性は検証されていない。また、計算コストの高いTransformerを含むため、リアルタイム処理における遅延対策が課題となる。今後は多品種・多環境での検証と、モデルの軽量化が求められる。
日本での適用可能性
日本では輸入バナナの品質管理や、国内栽培の高級バナナ選別にこの技術が応用できる。等級ごとのドメインシフトに対応できるため、入荷ロットごとの再学習を最小限に抑え、運用コストを削減する。既存の選別ラインへの統合を想定し、カメラ設置環境の最適化と、日本市場特有の品質基準に合わせた微調整が必要となる。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: Enhancing Cross-Grade Generalization in Banana Variety Classification via Hybrid CNN-Transformers and Knowledge Self-Distillation – 著者: Khush Kataruka, Mohammad Muzammila, Zahid Akhtar, Raghavendra Ramachandra, Praveen Kumar Chandaliya – 発表日: 2026-10-21 – arXiv ID: 2610.29008v1 – カテゴリ: cs.CV