✨ 本論文の新規性
- 症状と対比記述を統合したテキストプロトタイプを構築し、類似病害の区別を強化
- 画像内の局所領域から病害証拠を抽出し、グローバル特徴の希薄化を補正する仕組み
- 2段階適応により、特定タスクへの過剰適応を防ぎつつ汎用性を維持
- PlantVillage等で16-shot時に最高精度96.56%を達成し、従来手法を上回る
論文の主張: 限られた画像データで植物病害を高精度に判定するため、CLIPモデルに症状記述と局所証拠を組み合わせる新手法を提案。PlantVillageなどで最高精度を記録し、現場でのデータ不足課題への解決策を示す。
今回取り上げるのは、武漢大学の研究チームによる論文です。「記述ガイド付きCLIP適応と局所証拠補正による少例植物病害認識」というタイトルで、2026年11月に公開されたものです。
少例学習で病害認識ですね。AI技術の応用は進んでいますが、これはどのような課題を解決しようとしているのですか。
農家現場では、病害画像の収集や専門家によるアノテーションにコストがかかります。特に希少な病害では訓練データが不足しがちです。そこで、事前学習済みモデルCLIPの視覚と意味の知識を活用し、少ないサンプルでも精度を出す方法が提案されています。
なるほど。既存のCLIPベース手法では、クラス名などの大まかな意味情報に頼るため、病斑の色や形といった微細な診断情報が見落としがちだったのですね。
その通りです。この研究では、症状の記述や類似クラス間の差異を示す記述を導入し、クラスの意味表現を強化しています。さらに、画像全体ではなく、病変部分といった局所的な証拠を拾い上げて、マッチングを補正しています。
局所証拠の補正が鍵になるわけですね。ただ、少例のデータでモデルを強く適応させすぎると、他の環境では使えなくなるリスクも考えられます。この点はどのように処理されているのでしょうか。
適応プロセスを二段階に分けることで、課題と汎化のバランスを取っています。第一段階では軽量なパラメータ更新でタスク固有の表現を学習し、第二段階ではエンコーダを凍結して線形分類器を訓練します。
段階的な処理で過学習を抑えているのですね。実際の性能として、どの程度の精度が出ているのか、数字を教えていただけますか。
ViT-L/14モデルを用いた16ショット設定では、PlantVillageで93.16パーセント、カサバで79.30パーセント、 Pearで96.56パーセントの平均精度を記録しています。また、ドメインをまたいだ評価でも56.96パーセントを達成し、比較手法を上回りました。
数字としてはインパクトがありますね。特に異なる作物間での性能維持は、実運用において重要だと思います。導入コストや運用のしやすさについては、論文では触れられていますか。
論文自体はアルゴリズムの妥当性検証に主眼を置いていますので、具体的な経済性には言及されていません。ただし、軽量なパラメータ更新というアプローチは、計算リソースの制約がある現場での導入可能性を示唆していると言えます。
技術的な優位性は理解できました。経営側の視点では、精度向上が収益や省力化にどう結びつくか、という部分が見えてくると判断しやすいですね。
確かに、技術の実装と事業への適用にはギャップがあります。この手法は、データ不足に悩む農業現場において、診断精度を高める一つの選択肢となり得ます。一方で、現場の環境やデータ品質に依存する側面もあるため、慎重な検証が必要でしょう。
メリットと課題の両面があるというわけですね。興味深い研究でした。ありがとうございました。
背景と課題
植物病害の自動判定は農作物管理に不可欠だが、学習には大量のラベル付き画像が必要となる。現場では希少病害のデータ収集や専門家による注釈付けにコストがかかり、十分なデータを得るのが難しい。従来の深層学習は大量データに依存し、少データ環境では性能が低下する。また、既存のCLIPベース手法はクラス名などの粗い意味情報に頼り、病斑の色や形状といった細かな診断情報を捉えきれない。さらに、画像全体の特徴を用いるため、背景や健康な葉の部分に混じって、局所的な病害の兆候が薄まってしまう問題がある。
手法・アプローチ
本研究は「2SFS-SCL」と呼ばれる枠組みを提案する。まず、各病害の典型的な症状と類似病害との違いを記述したテキストプロトタイプを作成する。次に、画像の局所領域(パッチ)から病害に関連する証拠を集約し、これを画像全体のマッチング結果に反映させる。適応プロセスは2段階に分かれる。第1段階では、CLIPのエンコーダを軽量に更新してタスク固有の表現を学ぶ。第2段階では、エンコーダを固定し、初期化された線形分類器を最適化する。この分離により、少データでの過剰適応を防ぎ、事前学習由来の汎用性を保つ。
実験結果
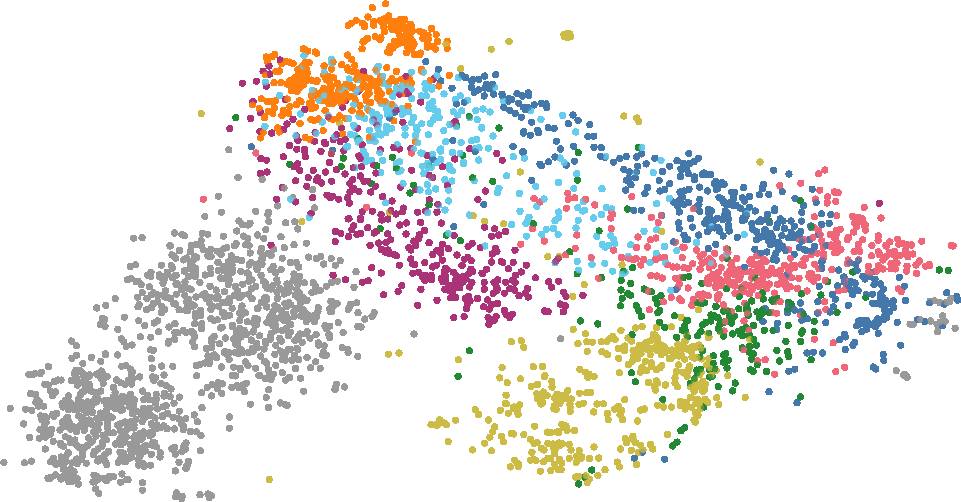
PlantVillage、Cassava、Pearの3データセットで評価を実施した。ViT-L/14モデルを使用し、16-shot設定での精度は、PlantVillageで93.16%、Cassavaで79.30%、Pearで96.56%を達成した。これらは比較手法の中で最高値である。また、異なる撮影条件のPlantDocデータセットを用いたクロスドメイン評価では、21クラス全体で56.96%の精度を記録し、分布シフト下でも安定した性能を示した。局所証拠の補正と記述ガイドによる意味強化が、細粒度な病害識別に有効であることを実証している。
意義・応用可能性
本手法は、大規模なアノテーション作業を大幅に削減できる点が大きい。農家や研究者が手持ちの少量画像で新たな病害モデルを構築可能になる。特に、発生頻度の低い希少病害や、地域特有の病害への対応が容易になる。スマートフォン撮影画像でも高い精度が出るため、現場での即時診断アプリへの組み込みが期待される。記述情報を利用するため、病害の専門家知識をシステムに組み込みやすく、判定根拠の説明性向上にも寄与する。
限界と今後の課題
クロスドメイン評価の精度は56.96%であり、標準的な少データ学習に比べると依然として低い。撮影環境や背景の複雑さが増すと、局所証拠の抽出が難しくなる可能性がある。また、症状記述の作成には農業の専門知識が必要であり、記述の質が性能に影響する。GPT-5.5を用いた対比記述生成は自動化されているが、誤った記述が含まれるリスクは残る。今後は、より多様な環境でのロバスト性向上や、記述生成の信頼性確保が課題となる。
日本での適用可能性
日本では梨やトマトなどの病害対策が重要であり、本手法はこれらの作物で有効だ。研究者が作成したPearデータセットでは96.56%の高精度を記録しており、国内の果樹園での活用が見込める。現場の農家がスマホで撮影した画像から、少データで病害を特定できるため、防除のタイミングを逃さない支援が可能になる。既存の病害図鑑の記述をテキスト情報として活用すれば、導入コストを抑えながら、地域ごとの病害特性に合わせたカスタマイズも実現できる。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: Description-Guided CLIP Adaptation with Local Evidence Calibration for Few-Shot Plant Disease Recognition – 著者: Zhenkun Ye, Qian Zhou, Hua Zou – 発表日: 2026-11-12 – arXiv ID: 2611.16373v1 – カテゴリ: cs.CV