📄 論文サマリー
著者:Mayur Pratim Das、Ajai Dubey、Aksshay Mathew P 他5名
発表:arXiv(コンピュータビジョン)/2610.22991v1
公開日:2026年10月16日
✨ 本論文の新規性
- 300万枚の農業画像で自己教師あり学習を実施し、ImageNet事前学習比で特徴抽出精度を2.56%向上させた
- CNNとTransformerを組み合わせたハイブリッド構造を採用し、局所纹理と全体文脈の両方を捉える
- ラベル付きデータの1%のみで作物分類98.01%を達成し、既存農業基盤モデルを14ポイント以上上回った
論文の主張: IIT Ropar等の研究チームが開発した農業向け視覚基盤モデル「A100」は、300万枚の無ラベル画像で事前学習。ラベルが1%しかない環境でも作物分類98.01%、病害検出99.02%の高精度を実現し、モデルを公開予定。
背景と課題
農業現場での作物監視や病害診断には、大量のラベル付きデータが必要だが、専門家によるアノテーションはコストが高く、特に発展途上国では不足している。既存の汎用画像認識モデルは、近接撮影された植物画像の細部を捉えきれない。また、既存の農業特化モデルはデータ規模が小さく、CNNのみで構成されるため、植物全体の形態を理解するグローバルな文脈処理に課題があった。
手法・アプローチ
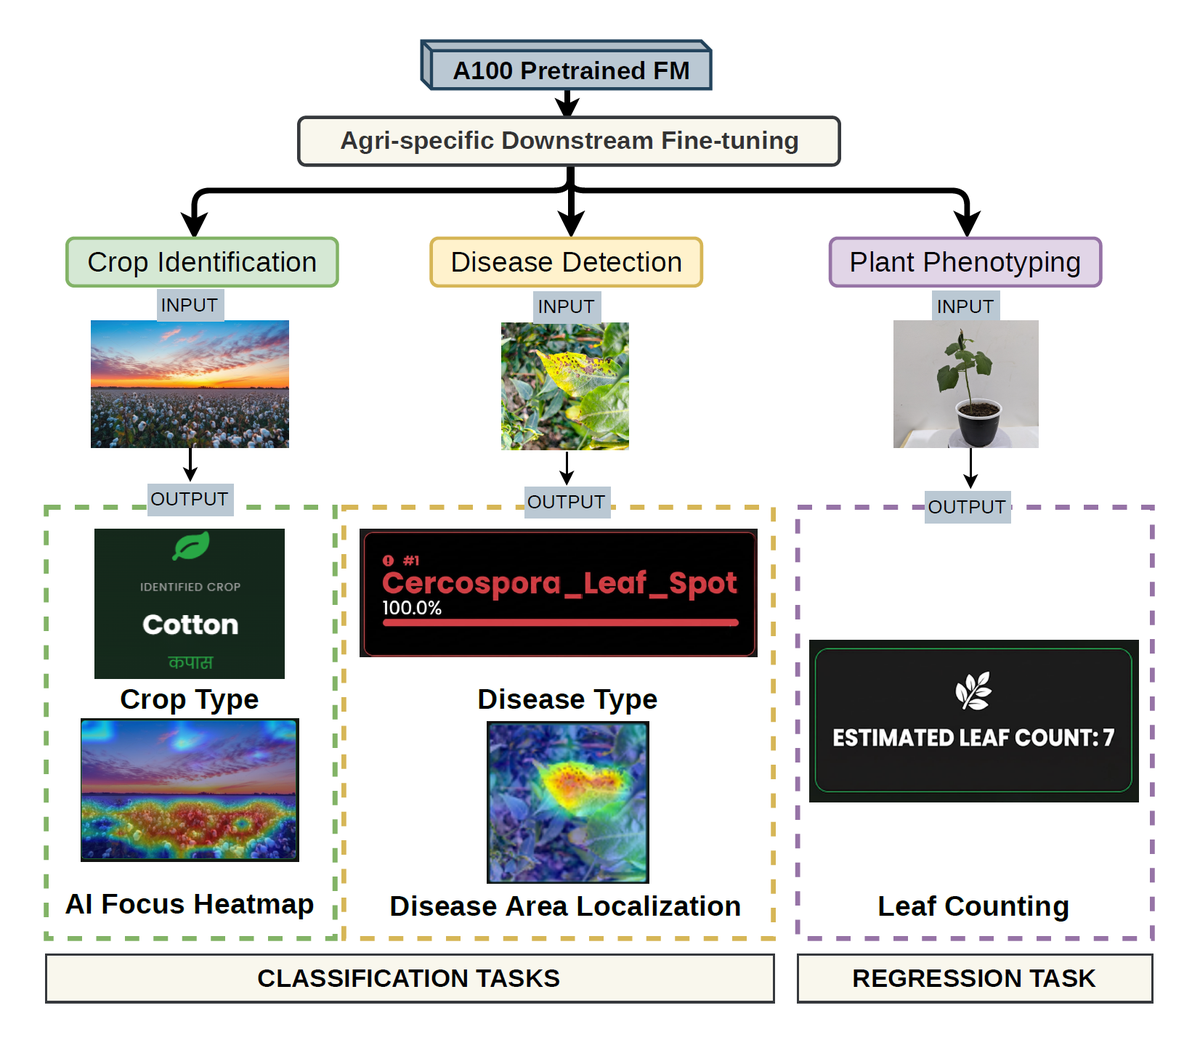
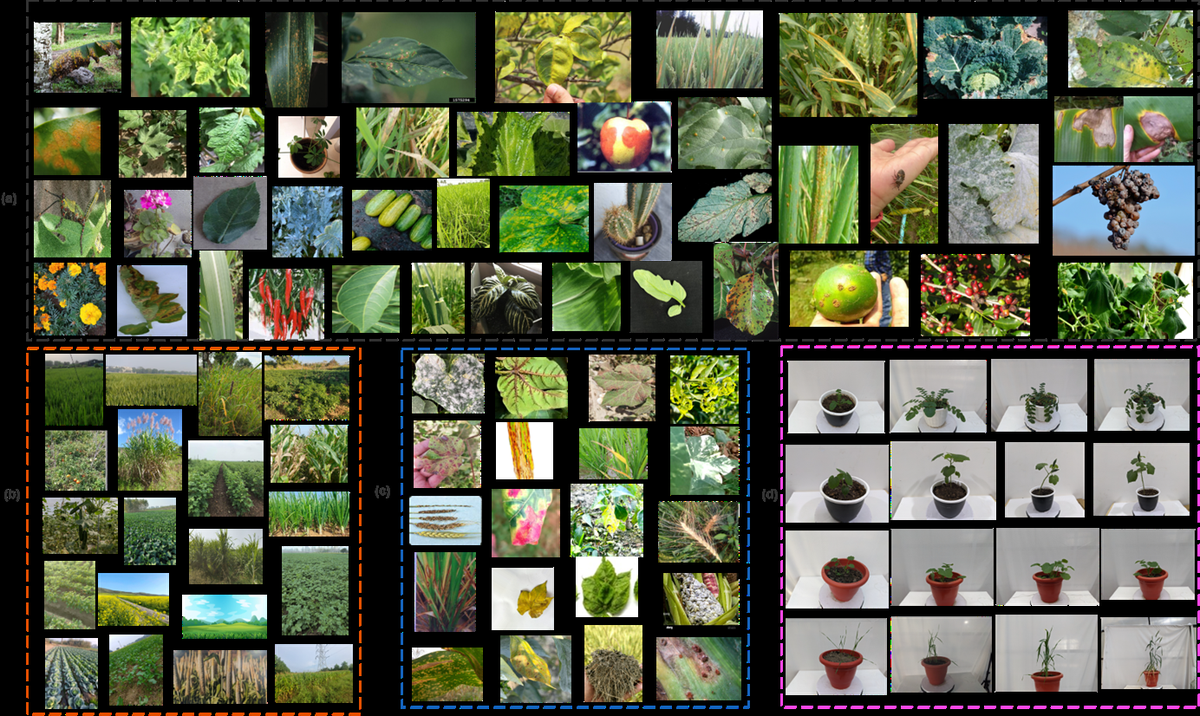
研究チームは、MBConvブロックによる局所特徴抽出とTransformerブロックによるグローバル文脈処理を組み合わせたハイブリッド構造の「A100」を開発した。100種類以上の作物を含む300万枚の無ラベル農業画像に対し、DINO自己蒸留、iBOTマスク再構成、KoLeo正則化を組み合わせた「SADG」手法で自己教師あり事前学習を実施。この多目的学習により、局所的な病斑と全体的な生育状態の両方を捉える汎用的な特徴表現を獲得した。
実験結果
A100は、32クラスの作物分類で99.90%、44クラスの病害検出で99.02%の精度を達成した。特にラベル付きデータが1%しかない環境では、作物分類で98.01%を記録し、ImageNet事前学習モデルを2.81ポイント上回った。既存の農業基盤モデル「FoMo4Wheat」や「LeafVision」との比較でも、1%ラベル条件下で14ポイント以上の優位性を示した。また、葉数推定タスクでは誤差を10.4%削減し、分類と回帰の両方で有効性を証明した。
意義・応用可能性
A100は、事前学習済みモデルを公開する予定であり、農業現場でのAI導入ハードルを下げる。限られたデータ量でも高精度な診断が可能になるため、地域ごとの固有の病害データが少ない場合でも、既存モデルを微調整するだけで実用化できる。スマートフォンでの近接撮影画像に対応しており、農家による簡易的な病害スクリーニングや、自動収穫ロボット向けの視覚システムへの組み込みが期待される。
限界と今後の課題
本研究は主にインドの農業現場からの画像データに基づいているため、日本の気候や栽培品種、撮影条件との差異が性能に影響する可能性がある。また、モデルパラメータ数は73Mと軽量だが、エッジデバイスでのリアルタイム処理にはさらなる最適化が必要かもしれない。今後は、多言語対応や、異なるセンサーからのデータ融合、さらなるデータセットの多様化が課題となる。
日本での適用可能性
日本では、高齢化による労働力不足と、高品質な農産物への需要から、AIによる病害早期発見が求められている。A100の少データ学習能力は、日本固有の品種や地域特有の病害データが少ない状況でも活用しやすい。公開されるモデルを基盤に、日本の農業試験場やスタートアップが自国データで微調整することで、米や野菜の精密農業システムへの実装が進むと考えられる。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: A100: A Hybrid Vision Foundation Model for Agricultural Plant Image Analysis – 著者: Mayur Pratim Das, Ajai Dubey, Aksshay Mathew P, Sana Afreen, Rishi Kumar Soni, Deepak Meena, Pratibha Kumari, Mukesh Saini – 発表日: 2026-10-16 – arXiv ID: 2610.22991v1 – カテゴリ: cs.CV