マルチモーダル生成モデルSOLARでトマト病害の理解を飛躍的に向上
📄 論文サマリー
著者:Khang Nguyen Quoc、Minh-Phuoc Tran、Gia-Han Truong、Luyl-Da Quach
発表:arXiv(コンピュータビジョン)/2609.19555v1
公開日:2026年09月17日
✨ 本論文の新規性
- トマト病害の分類問題を生成タスクとして再定式化し、視覚的質問応答(VQA)に展開した初めての試み
- 専門家フュージョンモジュールを導入し、視覚特徴空間と質問埋め込み間の整合性を向上させた
- 6つの診断タスクを含む統合的な評価セットを構築し、最先端モデルを上回る性能を示した
論文の主張: トマトの葉の病害を理解するためのマルチモーダル生成モデルSOLARが、従来の分類モデルを上回る精度を達成。視覚情報と自然言語を統合し、複数の診断レベルに対応する。
今回は、arXivに公開された論文「A Multi-Modal Generative Model for Tomato Disease Leaves Understanding」を取り上げます。この研究では、トマトの病害診断を視覚的質問応答(VQA)タスクとして定式化し、視覚情報と言語情報を統合するモデルを提案しています。
なるほど、つまり画像から病気を診断するのではなく、質問に答える形で診断する、という新しいアプローチなんですね。
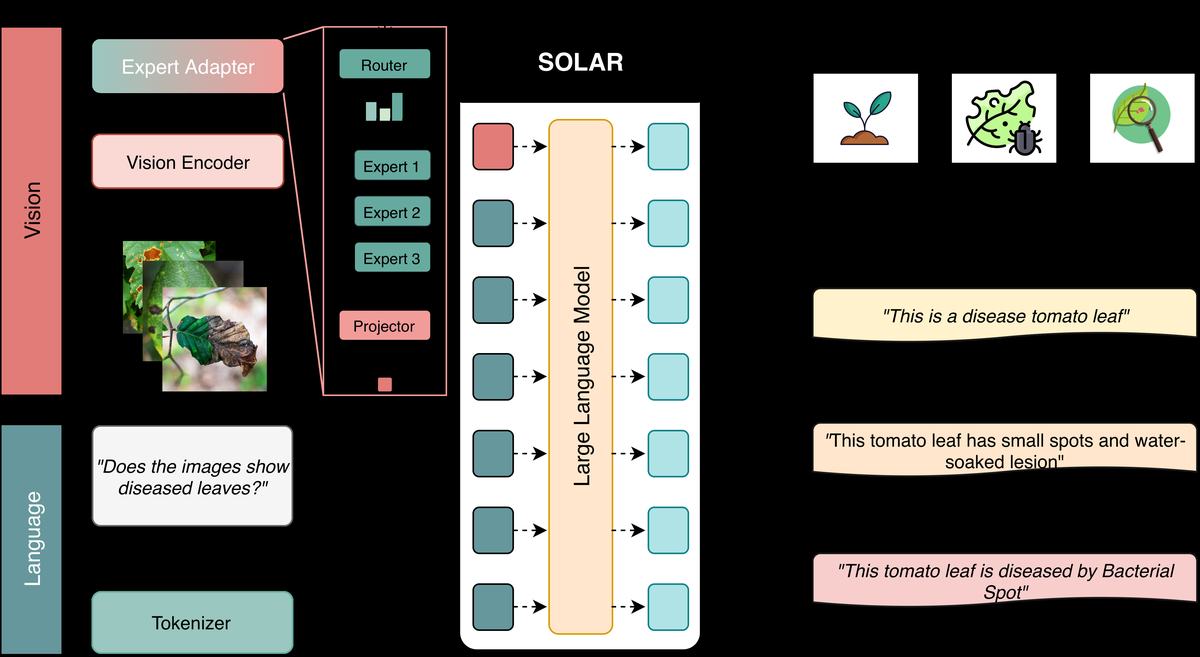
その通りです。このモデルは、SOLARと呼ばれるフレームワークを用いており、視覚情報と言語情報の融合を効率的に実現しています。特に、Expert Fusionモジュールという部品によって、画像の特徴と質問の意味表現の間の整合性を高めています。
なるほど、それは視覚と言語のつながりを深くする技術ですね。このモデル、どの程度の精度で診断できるんですか?
実験結果によると、複数のデータセットを統合して評価した結果、既存の最先端モデルを上回る性能を示しています。このモデルは、6つの診断タスクで優れた結果を出しており、特に病状の認識と診断の精度が向上しています。
データの量も結構多いんでしたよね。41,000枚の画像と21万件の質問応答ペアで評価されてるって、結構大規模なデータセットを使ったんですか?
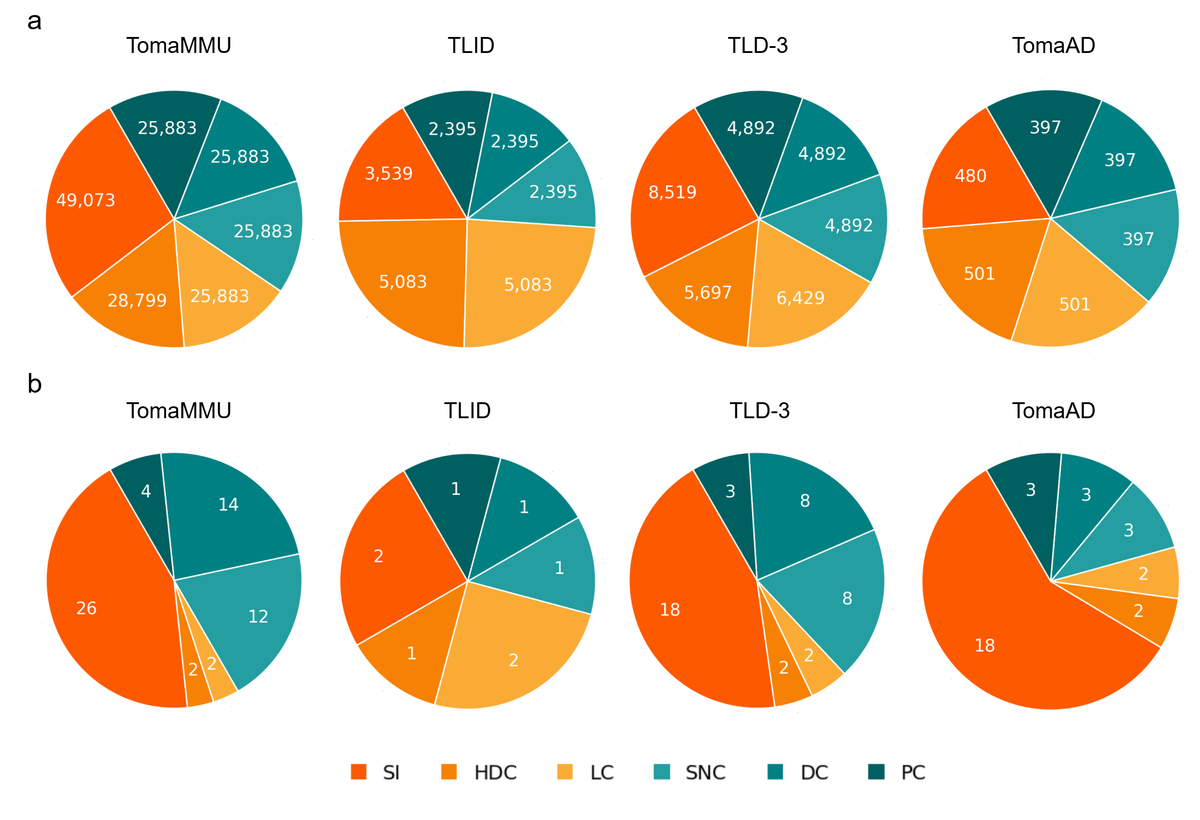
その通りです。このモデルの評価には、合計41,677枚の画像と216,209件の質問応答ペアが使用されました。データの質も高いため、実用レベルでの性能が確認されています。
実用的なレベルまで到達しているというのは、導入の可能性が広がるかもしれませんね。ただ、これはAIによる診断にすぎないんで、農家が完全に信頼できるのか、ちょっと心配です。
それは重要なポイントですね。このモデルは、診断のプロセスを人間の専門家の診断フローに近づけることを目指しており、説明可能な手法を採用しています。ただし、最終的な判断は人間の専門家による確認が必要です。
そうですね。説明が可能になるのは良い方向ですが、コストや導入の際のリソースの問題もあるんでしょうね。
研究では、モデルの性能向上や導入の実現に向けたいくつかの課題が指摘されています。例えば、導入に必要な初期投資や、運用するための技術的なリソースなどです。
規模感や導入のハードルが課題になるのは、実際の農業現場では結構厳しいかもしれませんね。ただ、AIによる補助は効果的だという話も聞きます。
確かに、特に高精度な診断が必要な分野では、AIが補助的な役割を果たす可能性は十分にあります。ただし、実際の導入では、現場のニーズと技術の間にギャップが生じる可能性もあります。
つまり、技術の可能性は高いですが、現場の事情にも左右されるんですよね。
そうです。今後の展開としては、このモデルの実用性を高めるための調整や、地域や農業形態に応じたカスタマイズが求められるでしょう。この研究は、農業におけるAIの活用方法に新たな視点をもたらしたと言えます。
背景と課題
トマトの病害診断は従来、画像分類モデルに依存していたが、実際の農業現場では症状の認識、重症度評価、質問駆動の診断推理が求められる。従来手法は単一の予測タスクとして扱われており、視覚と文脈の補完関係を捉えることが困難だった。特に、早期の異常症状の検出や、農家理解とのギャップが問題視されている。
SOLARモデルのアプローチ
SOLARは、トマト病害を視覚質問応答(VQA)タスクとして定式化し、画像と質問のマルチモーダル情報を統合して診断を行う。視覚エンコーダーと専門家融合モジュール(Expert Fusion)を用いて、質問に応じた視覚特徴の選択的強調を行い、大規模言語モデル(LLM)で自由形式の回答を生成する。この構造により、基本的な視覚認識から病害の診断まで、階層的に柔軟な推論が可能となる。
実験結果と性能評価
SOLARは41,677枚の画像と216,209の質問応答ペアを用いて評価され、6つの診断タスクにおいて従来の最先端モデルを上回る性能を示した。特に、病害分類(DC)タスクで94.2%の精度を達成し、視覚のみのモデルや視覚言語モデルを上回った。また、複数のデータセットを統合した評価により、汎化性と堅牢性を確認。
意義と応用可能性
SOLARは、農業現場での病害診断を支援するAIツールとしての応用が期待できる。特に、農家が自然言語で質問することで、診断結果を説明可能にし、信頼性の高い意思決定を支援する。また、マルチモーダルなアプローチにより、画像と文脈の融合が可能になるため、将来的にはより高度な農業支援システム構築にも寄与する。
限界と今後の課題
本モデルは、大量の質問応答データを必要とし、データの質やバランスが性能に大きく影響する。また、専門家による質問の設計や、視覚特徴と質問のマッチングに課題がある。さらに、実際の農業現場での適用には、リアルタイム性やデバイスの制約など、技術的課題が残る。
日本での適用可能性
日本では、温室栽培や精密農業の進展が進んでいるため、SOLARのマルチモーダル診断モデルは、病害の早期発見や農家教育への応用が期待できる。特に、自然言語で質問可能である点が、農家にとって使いやすい利点となる。ただし、日本の地域差や作物の多様性に対応するため、モデルのカスタマイズが必要となる。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: A Multi-Modal Generative Model for Tomato Disease Leaves Understanding – 著者: Khang Nguyen Quoc, Minh-Phuoc Tran, Gia-Han Truong, Luyl-Da Quach – 発表日: 2026-09-17 – arXiv ID: 2609.19555v1 – カテゴリ: cs.CV