📄 論文サマリー
著者:Amina Asif、Qurat ul ain Asif、Noor Bakhat Asif
発表:arXiv(コンピュータビジョン)/2610.07059v1
公開日:2026年10月05日
✨ 本論文の新規性
- 公開データセットの結合処理による「9倍重複」を検知し、ランダム分割でのR2=0.991という高評価が、実際には同一データの暗記による過学習であることを証明した
- 時系列依存性を考慮したLeave-One-Year-Out検証やFAOSTAT公式データでの再検証を実施し、複雑な機械学習モデルよりも単純な線形トレンドモデルが優位であることを示した
- MobileNetV2による葉の健康度分類と収量予測の統合を試みたが、画像と収量データのペアが存在しない場合、構築した健康度スコアは予測精度に寄与しないことを実証した
論文の主張: パキスタン・パンジャブ州の作物収量予測において、データ結合時の重複により機械学習モデルの精度が虚偽に高まる現象を指摘。厳密な時系列検証では複雑なモデルは失敗し、単純なトレンド分析が最良となる結果を示した。
今回紹介するのは、パキスタンのパンジャブ州における作物収量予測に関する論文です。ランダムフォレストやXGBoostなどの機械学習モデルと、葉の健康度を判定する画像認識を組み合わせたプロトタイプを開発しました。しかし、この研究の核心は、高い精度を示した初期結果が、データの重複という検証手法の欠陥によって過大評価されていたことを暴露し、再検証を行った点にあります。
なるほど、単に精度が出たという話ではなく、その背後にある検証プロセスの問題点が注目されているわけですね。特に印象的だったのはどこでしょうか。
最も衝撃的なのは、ランダムな分割による検証では決定係数R2が0.991とほぼ完璧な精度を示していたにもかかわらず、年単位でホールドアウト検証を行うと、その値がマイナスに転落した点です。これは、訓練データとテストデータに同じ作物・年の複製が含まれていたため、モデルが記憶していただけだったことを示唆しています。
えっ、それはかなり深刻ですね。実運用では、来期の収量を当てにいくのが目的なので、この検証の甘さは致命的です。現場の判断基準として使えなかったということですよね。
その通りです。研究者たちは、データソースであるKaggleのテーブルに、9年分の温度記録を結合した際に、各作物・年を9回複製してしまうという人為的なミスがあったと分析しています。これを修正し、FAOのデータセットで再検証したところ、複雑な機械学習モデルよりも、単純な線形トレンド分析の方が高い精度を出すという結果になりました。
複雑なAIモデルよりも、過去の傾向を示すシンプルな直線の方が強かった、と。ビジネスの世界でも、高度な分析ツールを導入する前に、基本的なトレンドを把握することの重要性はよく言われますが、これほど明確な例は少ないですね。
さらに興味深いのは、農薬使用量や気候変動が収量に与える影響を調べた部分です。元のデータでは農薬の使用が収量増に寄与しているように見えましたが、FAOのデータセットでは、農薬のシリーズが大部分補完データであり、効果を実証できませんでした。また、葉の健康度分類器は画像認識としては高い精度を出しましたが、収量データとのペアがないため、実際の予測モデルには寄与しませんでした。
「見かけ上の効果」がデータ処理のアーティファクトだったわけですね。投資判断で言えば、ROIの根拠となったデータ自体が信頼性を欠いていたということになります。こういうことは、外部のデータセットを使う際にありがちですが、ここまで徹底して検証するのは大変そうです。
はい、だからこそこの論文は「ネガティブファインディング」を報告する意義を強調しています。パンジャブ州の小麦データで独立したパネル分析を行ったところ、地域ごとの平均値と共通トレンドでモデルの予測とほぼ同等の結果が得られました。つまり、現段階では、高度なAIよりも、地域特性と時間トレンドを考慮したシンプルな統計モデルが実用的である可能性が高いということです。
なるほど。技術的な華やかさよりも、データの質と検証方法の厳密さが、最終的な成果物を左右するわけですね。導入コストやメンテナンス性を考えると、まずは単純なモデルから始める方が、コスト対効果は高そうです。
その通りです。研究チームも、このプロトタイプがパキスタンでの類似プロジェクトの出発点として有用であるとしつつ、その限界を明確に述べています。葉の画像と収量のペアデータが存在しない現状では、画像からの健康度評価は収量予測には繋がらない、と結論づけています。
データがないなら無理やりこじつけない、という姿勢は誠実ですね。業界でも、AIブームで無理やり適用範囲を広げるケースを見受けますが、こういう「できないこと」の明示は、信頼性を高める上で重要だと思います。
データリークや検証バイアスは、農業に限らず多くの分野で懸念されている問題です。特に公共データを用いる場合、その由来や結合方法に注意を払う必要があります。この論文は、その具体的な事例として、非常に示唆に富むものと言えるでしょう。
確かに。新しい技術を検討する際、モデルの精度そのものよりも、その数字がどのように導き出されたのかを疑う視線が必要ですね。メリットと課題の両面を踏まえて、冷静に判断していくことが求められそうです。
ええ。この研究は、農業におけるデータサイエンスの「落とし穴」と「再出発のヒント」を同時に提供しています。今後の動向が注目される事例ですね。
背景と課題:公開データの落とし穴
農業の生産性向上や輸入計画において、作物収量の正確な予測は不可欠です。しかし、多くの研究が公開されている小規模な農業データセットを用いており、検証方法の甘さから「見かけ上」高い精度を報告するケースが後を絶ちません。本研究は、パキスタン・パンジャブ州の小麦とトウモロコシの収量予測を目的とし、気候データや土壌情報、さらには葉の画像解析を組み合わせたプロトタイプを開発しました。当初、スタッキングアンサンブルモデルはテストセットでR2=0.991という驚異的な精度を記録しましたが、著者らはこの結果がデータの構造的な問題によるものではないかと疑い、詳細なデータ監査を行いました。
手法と検証:重複データの発見と再評価
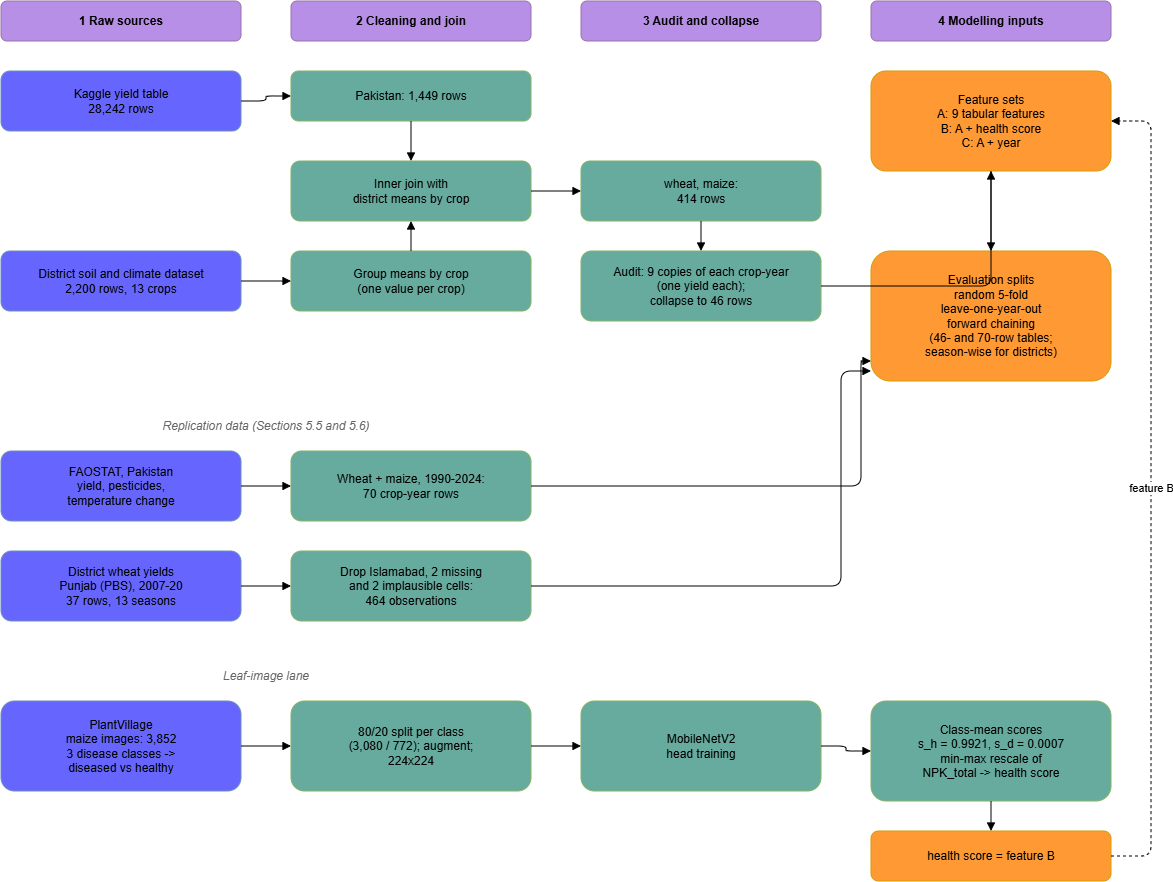
著者らは、Kaggle由来の414行のデータテーブルを監査した結果、これが実際には46の独立した観測値(作物年)を9回ずつ複製したものであることを発見しました。これは温度データの結合処理によるアーティファクトです。通常のランダム80/20分割では、同じ作物年のコピーが訓練データとテストデータの両方に含まれるため、モデルは「暗記」によって高い精度を出してしまいます。そこで、著者らは同一年のデータをまとめて保持する「Leave-One-Year-Out (LOYO)」や、過去のみで学習し未来を予測する「Forward Chaining」といった、時系列依存性を考慮した検証プロトコルを導入しました。また、MobileNetV2を用いた葉の健康度分類器も開発し、収量モデルへの統合を試みましたが、画像と収量のペアデータがないため、健康度スコアはNPK値から人工的に構築されました。
実験結果:複雑なモデルの失敗とトレンドの勝利
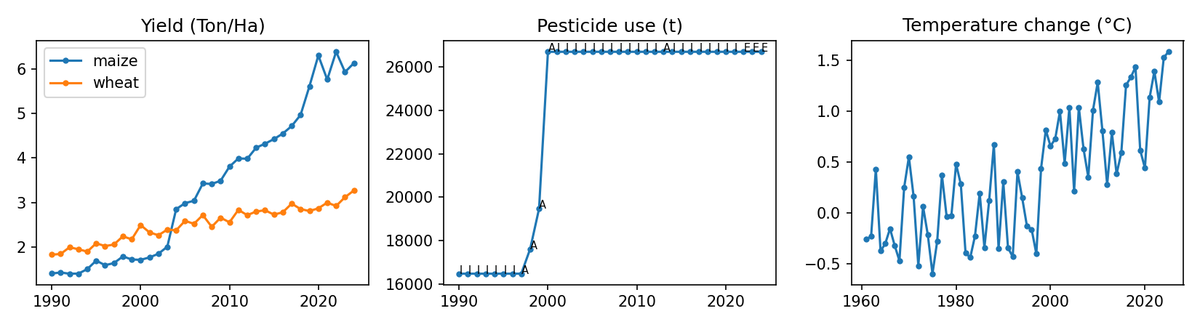
検証方法を変えるだけで、結果は劇的に変化しました。XGBoostモデルはランダム分割ではR2=0.994を示しましたが、LOYO検証ではR2=-0.204となり、平均値予測よりも悪い結果に落ち込みました。重複を除いたデータや、FAOSTATから再取得した1990-2024年の長期データ(70観測値)を用いても、複雑な機械学習モデルは線形トレンドモデル(LOYO RMSE 0.29 Ton/Ha)に勝てませんでした。さらに、当初有効に見えた農薬使用量の特徴量は、FAOSTATデータでは大部分が補間値(imputed)であり、実際の説明力がないことが判明しました。葉の健康度分類器自体はPlantVillageデータセットで99.87%の精度を出しましたが、収量予測への寄与はゼロでした。
意義と応用:農業AIにおける「誠実な検証」の必要性
本研究の最大の貢献は、農業分野の機械学習において、データの前処理や検証プロトコルの選択がいかに結果を歪めるかを具体的に示した点にあります。特に、公開データセットの結合処理が意図せずデータリークを引き起こすリスクは、他の研究者にとっても重要な教訓です。また、地域レベルの小麦パネルデータ(36地区、13シーズン)を用いた検証では、パンジャブ州の収量変動の多くは空間的なものであり、単一の地域平均と共通トレンドで十分に説明できることが示されました。これは、複雑なAIモデルを導入する前に、ベースラインとなる統計的手法との比較検証が極めて重要であることを意味しています。
限界と今後の課題:データギャップの克服
本研究にはいくつかの重要な限界があります。第一に、葉の画像データと収量データの直接的なペアが存在しないため、画像解析による健康度スコアが収量予測にどのように寄与するかを厳密に評価できませんでした。第二に、農薬使用量などの入力データが補間値や推定値に依存しており、実際の現場の管理状態を反映していない可能性があります。第三に、検証に使用したデータセットの規模が小さく、長期的な気候変動や新しい病害へのロバスト性は確認されていません。今後の課題としては、画像と収量を同時に記録する大規模なフィールドデータの収集、および気象データや土壌センサーデータとのより密接な統合が挙げられます。
日本での適用可能性:データ品質管理の徹底
日本でも、営農支援システムや収量予測AIの開発が進んでいますが、本研究の教訓は極めて重要です。日本の農業データも、気象庁データ、土壌マップ、営農記録など複数のソースから結合されることが多く、パキスタンの事例と同様に「重複」や「リーク」のリスクを抱えています。AIモデルを開発・導入する際は、ランダム分割だけでなく、年次や地域単位でのブロック分割による検証を必須とすべきです。また、複雑な深層学習モデルを導入する前に、単純なトレンド分析や統計モデルとの比較を行い、AIが本当に付加価値を生んでいるかを確認するプロセスを標準化することが、信頼できる農業AIの実装につながります。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: Crop Yield Prediction for Punjab, Pakistan: A Tree-Ensemble and Leaf-Health Prototype, and What Random Validation Hides – 著者: Amina Asif, Qurat ul ain Asif, Noor Bakhat Asif – 発表日: 2026-10-05 – arXiv ID: 2610.07059v1 – カテゴリ: cs.CV