📄 論文サマリー
著者:Rosemary Nalwanga、Sebastian Bunda、Godliver Owomugisha、Luuk Spreeuwers、Estefania Talavera Martinez
発表:arXiv(コンピュータビジョン)/2610.04456v1
公開日:2026年10月03日
✨ 本論文の新規性
- 米国、アジア、アフリカの6つの公開データセットを統合し、18作物・56病害クラスを含む16万7千枚規模の多地域統合ベンチマーク『MLD』を構築した
- 単一データセットでの学習では実現場画像(PlantDoc等)への転移でF1値が12.88%まで急落する現象を定量化し、データ多様性がモデル設計より重要であることを示した
- 作物種を先に判定してから病害を推定する階層型分類『HiLeaD』を導入し、フラット分類と比較して最大4.88ポイントのF1値向上を実現した
論文の主張: 実験室条件で学習した病害検出AIは、実現場の画像では精度が劇的に低下する。本研究は多地域データを統合した新ベンチマーク『MLD』を提案し、データ多様性の確保と階層型分類手法により、実現場での汎化性能を部分的に回復させることを実証した。
今回紹介するのは、マルチクロップ・リーフ・ディスク・レコグニションに関する研究論文です。アメリカやアジア、アフリカからの6つの公開データセットを統合し、18種類の作物と56の病害クラスを含む巨大なベンチマーク「MLD」を作成しました。既存のモデルは単一の環境下では高精度ですが、地域が変わると性能がどう落ちるのか、その「ドメインシフト」を徹底的に検証しています。
なるほど、単一の作物ではなく、複数の作物と地域をまたいだデータが鍵になっているわけですね。データセットの規模感としては、画像枚数が16万枚以上あるとのことですが、これは産業応用を見据えたものなのでしょうか?
規模は確かに大きいですが、重要なのは「制御された実験室条件」と「現実の農場環境」のギャップです。データで言うと、PlantVillageという実験室的なデータセットで学習したモデルは、病害のF1スコアが99.07%とほぼ完璧でした。しかし、それをアフリカのPlantDocという実際の農場画像でテストすると、わずか12.88%まで崩壊してしまったのです。
99%から12%へ、ですか。それは激しいですね。実用化を目指すビジネス側からすると、実験室での数字と現場での数字の乖離は致命的です。これでは現場導入は難しいですね。
はい、まさにそこが課題です。この乖離を埋めるために、研究者たちは「階層的な分類」のアプローチ、つまり作物の種類を予測してから病害を予測するHiLeaDという手法を試しました。これにより、PlantDocでの性能は12.88%から39.64%へと改善しました。約26ポイントの改善です。
数値としてのインパクトはありますが、それでも39%程度であれば、現場での信頼性にはまだ疑問が残りますね。モデルの設計自体で劇的に解決できるものではなく、データの多様性がボトルネックになっているということでしょうか。
その通りです。論文の結論でも、現在の進歩はモデル設計よりも、データの「カバレッジ」と「多様性」に制限されていると指摘されています。つまり、アルゴリズムの工夫だけでなく、いかに多様な地域・季節・栽培環境のデータを収集・統合できるかが勝負の分かれ目になります。
なるほど、AIの精度向上というよりも、むしろデータ整備の課題として捉えるべきなのですね。そうなると、初期投資やランニングコストよりも、データの集約体制や標準化へのコストの方が大きくなりそうです。
ええ、特に小規模農家が多い地域では、一人ひとりの圃場からのデータ収集は非効率になりがちです。この研究では、異なる国や機関のデータを一つの階層的な分類体系に統一することで、この課題にアプローチしようとしています。これは技術的な統合というよりも、データガバナンスの課題とも言えます。
データガバナンスですね。確かに、複数のプレイヤーが参加する場合、データの所有権やプライバシー、そして標準化への協調がハードルになりそうです。ビジネスとしては、この統合的なプラットフォームを誰が維持し、収益モデルをどう構築するかが気になるところです。
そこが難しいところです。この論文自体は学術的なベンチマークの提案であり、具体的なビジネスモデルまでは提示していません。ただし、共通の分類体系が整うことで、異なる開発者やスタートアップが開発したアプリ間での互換性が高まる可能性はあります。
互換性が高まるのは利点ですが、逆に言えば、既存の独自アプリが淘汰されるリスクもありますね。導入判断が悩ましいところです。現場の農家にとっては、結局「今使えるツール」が優先されますから。
そうですね。現状では、このMLDデータセット自体がオープンソースとして公開されており、研究者コミュニティでの検証が進んでいます。実運用に至るには、さらに現実的なフィールドでの長期検証と、ユーザーインターフェースの洗練が必要になるでしょう。
あくまで基盤となる「地図」が整備されつつある段階、と理解しました。メリットとして、地域をまたいだ学習が可能になる一方で、現場での信頼性確保にはまだ道のりがありそうです。選択肢としては面白いですが、実用化はまだ先と見た方が良さそうです。
背景と課題:実験室での高精度は現場で通用しない
小規模農家の食料安全保障にとって、作物病害の早期診断は不可欠である。近年、CNNやTransformerを用いた病害検出AIは、PlantVillageなどの実験室条件で撮影されたデータセットにおいて99%以上の高精度を報告している。しかし、これらの多くは単一のデータセットで学習・評価されており、背景が均一で照明が制御された「理想環境」での性能に過ぎない。実際の畑では、葉の重なり、複雑な背景、異なるカメラ、天候による光量変化など、学習時とは全く異なる条件(ドメインシフト)が生じる。既存研究では、この「実験室から現場への転移」における性能劣化が十分に検証されておらず、実用化への障壁となっていた。
手法:多地域統合データセット『MLD』と階層型分類『HiLeaD』
本研究は、米国、インド、ガーナ、ウガンダ、タンザニアの5カ国から収集された6つの公開データセット(PlantVillage, PlantDoc, CCMT, MAK, NMAIST, PSFD-Musa)を統合し、18作物・56病害クラス(健康クラス含む)からなる167,427枚の画像を擁する新ベンチマーク『MLD』を構築した。評価には、ResNet-18をバックボーンとした2つのアプローチを比較した。1つは全クラスをフラットに分類する従来型、もう1つは「作物種」を先に判定し、その作物に紐づく病害のみを候補とする階層型分類『HiLeaD』である。HiLeaDは、生物学的な制約(特定の病害は特定の作物にしか発生しない)をモデルに組み込むことで、誤検出を抑制し、解釈可能性を高める設計となっている。
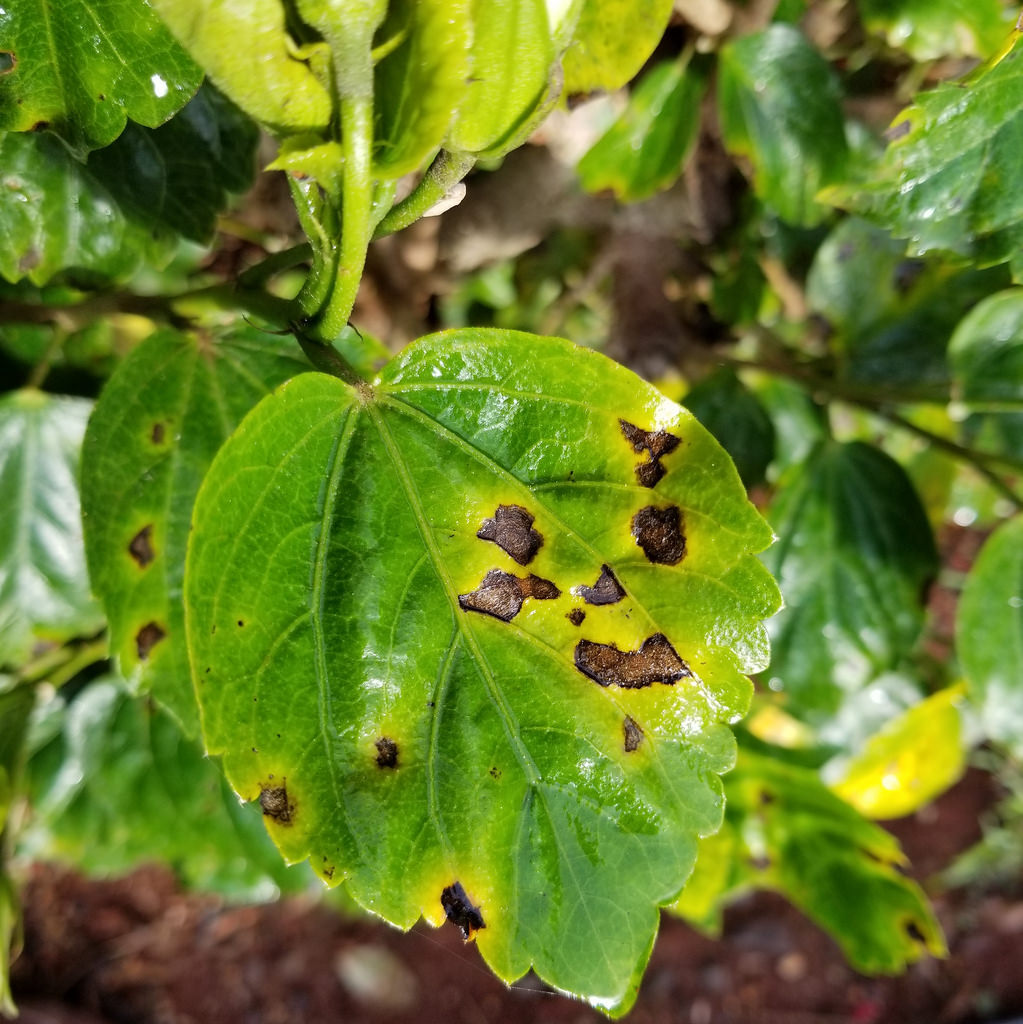
実験結果:データ多様性が精度低下を緩和する
実験により、単一データセットでの学習では深刻な性能劣化が生じることが明らかになった。実験室画像中心のPlantVillageで学習したモデルは、同データセット内では病害F1値99.07%を達成するが、実現場画像のPlantDocでは12.88%まで急落した。一方、6データセットを統合した『MLD』で学習したHiLeaDモデルは、PlantDocでのF1値を39.64%まで回復させ、単一データセット学習比で26.76ポイントの改善を実現した。また、階層型分類(HiLeaD)はフラット分類に対し、MLDデータセット下で1.71〜4.88ポイントのF1値向上を示した。特に、学習データにノイズの多い現場画像が含まれる場合、その特徴が実験室画像への転移にも有効であることが示唆された。
意義と応用:現場対応型AI開発への指針
本研究の最大の貢献は、「モデルアーキテクチャの改良よりも、学習データの地理的・環境的多様性を確保すること」が、実現場でのAI性能維持に極めて重要であることを定量的に示した点にある。従来の研究では、新しいネットワーク構造を提案することで精度向上を図る傾向が強かったが、本結果はデータ収集戦略の重要性を再認識させるものである。また、HiLeaDのような階層型アプローチは、作物種が既知である場合(例:圃場ごとに作物が決まっている場合)や、新しい作物・病害を追加する際の拡張性において有利であり、モジュール型AIシステムの構築に寄与する。
限界と今後の課題:依然として残る現場ギャップ
MLDデータセットでの学習により性能は改善されたものの、実現場画像(PlantDoc)での病害F1値は39.64%にとどまり、実験室での99%超には遠く及ばない。これは、現場画像の複雑さ(重なり、汚れ、変形)に対して、現在のデータ量や多様性では依然として不十分であることを意味する。また、HiLeaDの階層構造は、作物種の判定自体が失敗した場合、病害判定も連鎖的に失敗するリスクがある。今後の課題は、より多様な地域・気候条件でのデータ収集、および作物判定エラーに対するロバスト性の向上、さらには少学習(Few-shot learning)技術の適用による追加データ収集コストの削減が挙げられる。
日本での適用可能性:多品目栽培への展開
日本では、トマト、イチゴ、キュウリなど施設栽培が盛んであるが、露地栽培や多品目混植圃場では背景の複雑さが課題となる。本研究が示した「多地域・多条件データの統合」の重要性は、日本の農業現場でも同様である。例えば、国内の異なる地域(北海道と九州など)や、異なる撮影環境(ドローン、スマホ、固定カメラ)で収集した画像を統合した学習データセットを構築することで、国内の多様な圃場条件に対応できる汎用的な病害検出AIの開発が可能になる。また、HiLeaDの階層構造は、作付け計画に基づいて作物種を絞り込むことで、誤検出を減らし、農家向けの信頼性の高い診断ツールとして応用できる。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: Multi-Crop Leaf Disease Recognition: A Unified Benchmark and Cross-Region Study – 著者: Rosemary Nalwanga, Sebastian Bunda, Godliver Owomugisha, Luuk Spreeuwers, Estefania Talavera Martinez – 発表日: 2026-10-03 – arXiv ID: 2610.04456v1 – カテゴリ: cs.CV