✨ 本論文の新規性
- Mamba系SSM向けに特化した機械学習アンラーニング『SSU-LSF』を初開発し、非定常な混入事象の影響を除去
- EKFac影響関数と空間TV正則化を組み合わせ、パラメータ空間でバイアスを局所化し空間的一貫性を維持
- 再学習比8.4倍の低コストで、NDVIやLST予測の混入除去率(CRR)0.77〜0.86を実現
論文の主張: 灌漑やセンサー校正など、学習データに混入した非定常なノイズが、Mambaモデルの予測に長期的なバイアスとして残る問題を解決する手法『SSU-LSF』を提案。再学習不要で、精度低下を抑えつつバイアスを除去します。
今回紹介するのは、農業予測の精度を妨げる「隠れたバイアス」を、機械学習モデルから効率的に消去する「SSU-LSF」という手法に関する論文です。Mamba型の状態空間モデルが、灌漑の急増やセンサー誤差といった非定常な事象を「記憶」してしまい、その後のNDVIなどの予測値を歪める問題を解決しようと試みたものです。
なるほど、予測モデルが「間違った経験則」を持ってしまうのを直す話ですね。通常、モデルを直すなら再学習が必要かと思うのですが、この手法の最大の特徴はどこにあるのでしょうか?
そこが面白いところで、この手法は「アンラーニング(忘却)」に特化しています。従来の再学習ではGPUで47時間以上かかるのに対し、SSU-LSFは3〜5エポックで収束し、コストを約1/8.4に抑えつつ、汚染された領域の誤差を77〜86%削減できることが示唆されています。
コストが1/8で済むのは経営的には非常に大きいですね。ただ、モデルの一部を「消す」わけですから、消す範囲が間違っていると、正常な予測まで壊れてしまうリスクはないのでしょうか?
その懸念に対して、この研究では「空間的な総変動(TV)正則化」という手法を導入しています。これにより、パラメータ空間において、隣接する領域との平滑性を保ちながら更新を行うことで、正常なドメインでのRMSE(二乗平均平方根誤差)の劣化を最小限に抑える設計になっています。
つまり、特定の汚染部分だけをピンポイントで削るのではなく、周辺との整合性を保ちながら修正するわけですね。技術的な難易度は高そうですが、現場での実装ハードルはどう見られていますか?
実装面では、影響関数を閉形式で計算する「EKFac」という独自のアルゴリズムを用いています。複雑なヘシアンの計算を回避し、勾配上昇法とKLダイバージェンスの制限を組み合わせて、安定した収束を実現しています。ただし、これはあくまで研究レベルの成果であり、運用システムの統合にはさらなる検証が必要でしょう。
データサイエンティスト側での導入は比較的スムーズそうですが、この「汚染された期間」を人間が特定する必要があるのでしょうか? もし人間が間違えたら、修正も失敗しますよね。
はい、現状では汚染期間の開始と終了のウィンドウを提供する必要があります。論文では、実データであるEUMETSATの校正イベントを検証に使っていますが、実際の運用では、灌漑計画の変更やセンサー故障のログなど、外部情報と照合してこのウィンドウを特定するプロセスが不可欠となります。
外部データの整備やログの精度管理が前提条件になるわけですね。技術自体は魅力的ですが、運用側のコストや体制整備がボトルネックになりそうです。
その通りです。この手法の意義は、一度学習したモデルを「使い捨て」にせず、継続的に品質を保つための「維持コスト」を劇的に下げられる点にあります。農業の長期予測において、モデルの更新頻度と精度のバランスをどう取るかという議論において、重要な選択肢の一つになり得るでしょう。
メリットと課題、両方が見えてきました。再学習のコストを下げる可能性はありますが、運用の複雑さが増す面もありますね。今後の実証実験の進展が楽しみです。
ええ、農業分野でのAIモデルの「メンテナンス」をどう最適化するか、という視点で注目していきたいですね。ということで、今日はここまでです。
背景と課題:農業AIに潜む「静かなバイアス」
近年、NDVI(植生指数)やLST(地表温度)の予測には、Mambaなどの構造化状態空間モデル(SSM)が採用されています。しかし、運用中のデータには、記録されていない灌漑の急増やダム操作の変更、センサー再校正といった「非定常な混入事象」が含まれることがあります。これらの異常値がSSMの状態遷移行列に吸収されると、物理的な原因が終わった後も、モデルは誤ったパターンを学習し続け、長期的な予測精度を静かに低下させます。従来の全再学習は47 GPU時間以上かかり、既存のアンラーニング手法は空間的な一貫性を損なうか、精度が大きく劣化するという課題がありました。
手法:『SSU-LSF』によるバイアスの局所除去
本研究では、Mamba系SSMに特化した機械学習アンラーニングフレームワーク『SSU-LSF』を開発しました。まず、Mambaの状態行列向けに最適化した「EKFac影響関数」を用いて、どの学習ステップがバイアスを生んだかを特定します。次に、スペクトル半径に基づくしきい値で時間的な混入フットプリントを局所化します。その後、空間的な総変動(TV)正則化を組み込んだヘシアンフリー射影勾配上昇法により、KLダイバージェンスの制約下でパラメータを更新します。これにより、混入事象の影響だけをピンポイントで除去しつつ、正常な予測能力を保持します。
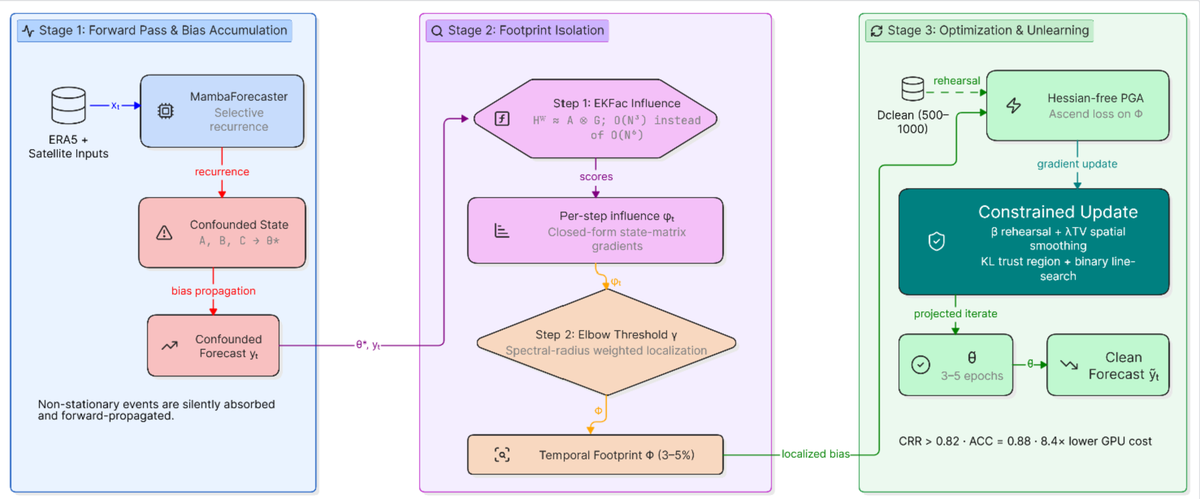
実験結果:再学習の1/8のコストで高精度を実現
3つのベンチマーク(CropHarvest, NDVI-LST, ERA5)で評価した結果、SSU-LSFは混入除去率(CRR)で0.773〜0.859を達成しました。特にERA5データセットでは、LiRA-style MIA(メンバーシップ推論攻撃)スコアが0.53と、ほぼランダム(0.50)に近い値を示し、混入された情報が完全に消去されていることを確認しました。一方、正常データに対するRMSEの劣化は最大でも4.2%に抑えられています。計算コストは、全再学習(47.3 GPU時間)に対し、リクエストあたり1.8〜5.6 GPU時間と、約8.4倍の効率化に成功しました。
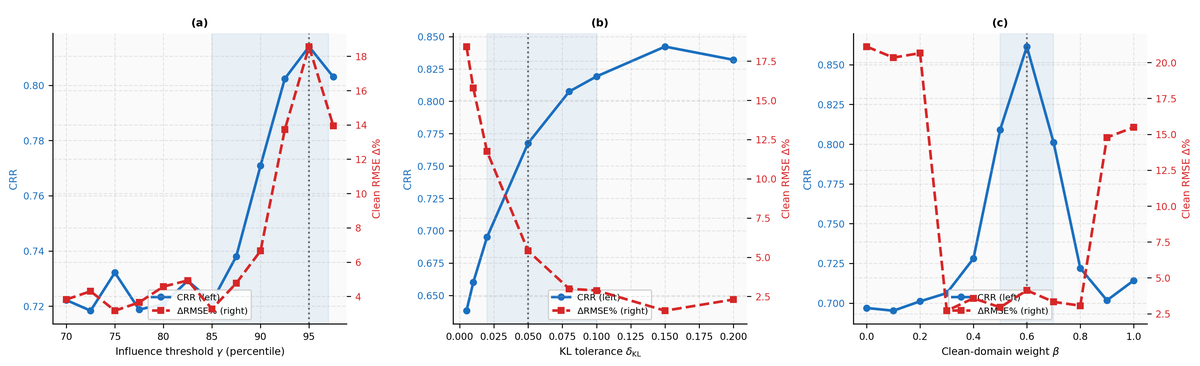
意義と応用:気象・農業機関の運用負荷軽減
SSU-LSFは、気象予報機関や農業支援システムにおいて、モデルの再学習なしにバイアスを修正できる点が大きな利点です。これにより、センサー故障やデータ入力ミスなどの緊急時にも、迅速かつ低コストで予測システムの信頼性を回復させることが可能になります。また、空間TV正則化により、地図上の局所的な異常値が周辺地域に誤って波及するのを防ぎ、広域の農業モニタリングにおける空間的一貫性を保ちます。
限界と今後の課題
本研究にはいくつかの限界があります。第一に、主要な実験は「混入期間の開始・終了時刻が既知」であるという前提(オラクルウィンドウ)で行われており、実際の運用ではこの検出自体が課題となります。第二に、理論的な誤差上限(Proposition 1)は、実測値と比較して約200倍ほど緩く、定量的な保証としては弱い点があります。第三に、混入事象の検出を自動化する仕組みや、複数の事象が重なる実データへの適用は今後の課題です。
日本での適用可能性
日本では、気象庁のERA5データや、農林水産省の衛星データを用いた作況予測が重要視されています。灌漑設備の更新や、観測網の再編成など、データソースの変化が頻繁に発生する現場において、SSU-LSFのような手法は、既存の予測モデルを捨てずに「リフレッシュ」する手段として有効です。特に、米や小麦などの広域作況予測において、局所的なデータ異常が全国規模の予測を歪めるのを防ぐために活用できる可能性があります。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: State-Space Unlearning for Non-Stationary Bias in Land Surface Forecasting – 著者: Anidipta Pal – 発表日: 2026-09-30 – arXiv ID: 2610.02248v1 – カテゴリ: cs.LG