📄 論文サマリー
著者:Yanan Wang、Yuzheng wang、Yibin Ying、Zhenghao Fei
発表:arXiv(コンピュータビジョン)/2611.25475v1
公開日:2026年11月19日
✨ 本論文の新規性
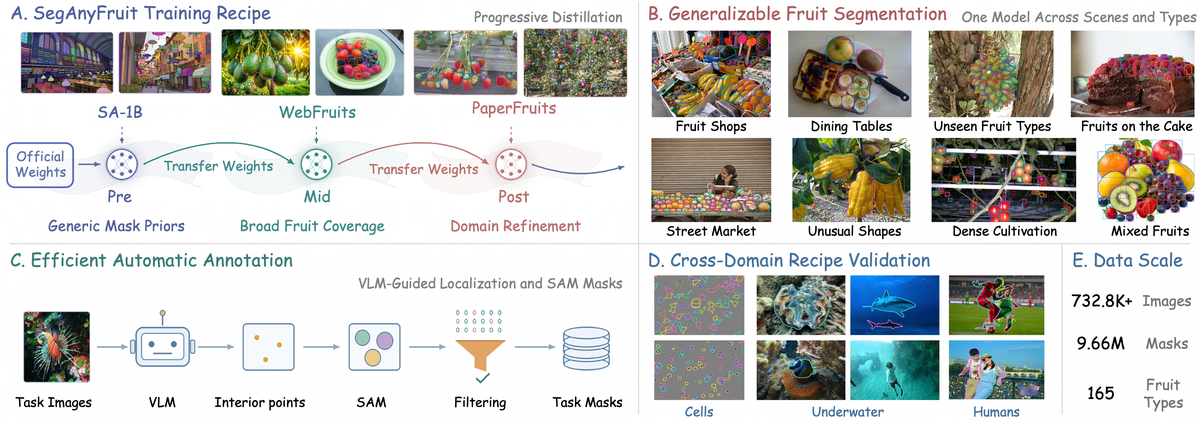
- 大規模Web画像と農業データを段階的に学習する「Pre-Mid-Post」訓練手法を開発し、プロンプト不要で未知の果実にも対応可能にした。
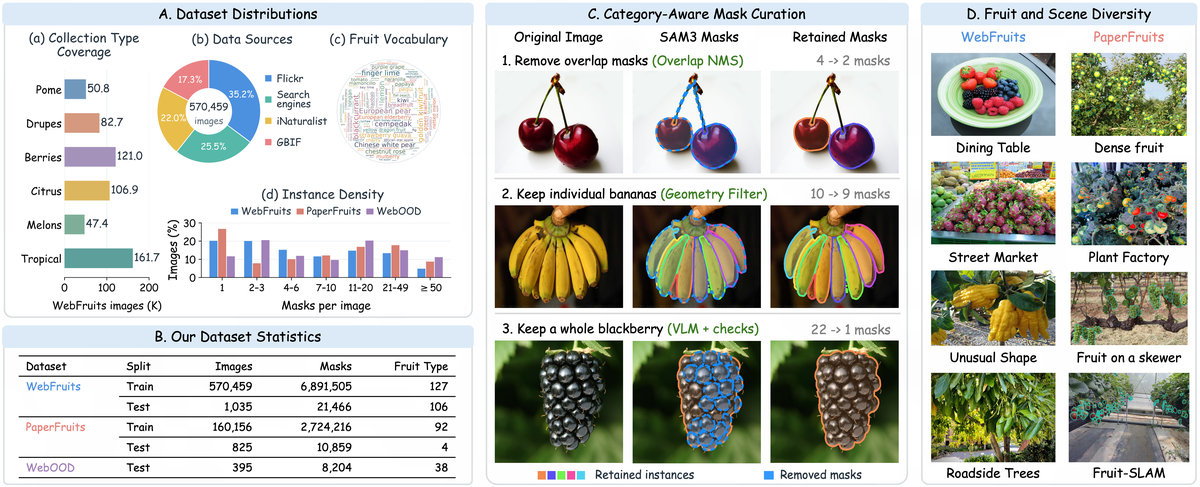
- 165種類・73万画像・966万マスクを含む大規模データセット「WebFruits」および「PaperFruits」を構築し、公開する。
- Jetson Orin NXなどのエッジデバイスで30FPS以上の高速推論を実現し、大型基盤モデル比で大幅な軽量化と精度向上を両立した。
論文の主張: SegAnyFruitは、Web画像と農業データを段階的に学習することで、未知の果実や環境でも高精度なインスタンスセグメンテーションを可能にする軽量AIフレームワークです。プロンプト不要でエッジデバイスでのリアルタイム処理を実現し、収穫ロボットや品質検査への応用が期待されます。
今回紹介するのは、セグメンテーション・エニィ・フルーツという論文に関する動画です。果物のインスタンスセグメンテーションを、軽量かつエッジデバイスで実行可能にするための枠組みについて解説しています。
果物の認識ですか。なるほど、面白そうですね。特に印象に残った技術的なポイントはどこでしたか。
基盤モデルの知識を、小型のセグメンターに蒸留する点です。ウェブ画像から自動アノテーションしたデータと、人間の検証済みデータを組み合わせ、学習させています。
自動アノテーションですか。データ量としてはどれくらいになるんでしょうか。
約73万枚の画像と、966万個のマスクを含んでいます。165種類の果物を対象にしており、規模感は相当なものですね。
数字としてはインパクトがありますね。ただ、精度と処理速度のバランスが気になります。現場での稼働を考えると、リソースの制約は厳しそうです。
そこが工夫のしどころです。ゼロショット推論でも平均マスク精度が69.06に達し、エッジデバイスでは30フレーム毎秒以上で動作します。
30フレーム毎秒なら、リアルタイム処理には十分ですね。導入コストとROIを考えると、既存システムとの置き換えを検討しやすい規模感でしょうか。
モデルの初期化により、少量のデータでも適応可能とされています。ただし、果物の種類や環境によって性能は変動するため、一律の判断は難しいところです。
なるほど。汎用性が高い一方で、条件次第というわけですね。補助金等の政策支援がない場合、中小規模での採算性は見出しにくいかもしれません。
はい。自動アノテーションによる労務コスト削減は見込めますが、初期投資と運用負担のバランスをどう取るかが課題になりますね。
技術的な進歩は確かにありますが、導入には地域や規模で判断が分かれそうです。メリットと課題、双方を理解した上で検討したいですね。
その通りです。データやコードは公開予定ですので、興味のある方は元論文や動画もぜひご覧ください。
ありがとうございます。これからの動向、気になりますね。今日はここまでです。
背景と課題
農業現場での収穫ロボットや収量推定には、果実の位置と形状を正確に切り出すインスタンスセグメンテーションが不可欠です。しかし、果実は種類や生育段階、葉による遮蔽、照明条件などにより外観が大きく変化するため、特定の環境で学習したモデルは別の果樹園や未知の品種で精度が低下します。また、高精度な基盤モデルは計算コストが高く、現場のロボットに搭載できるエッジデバイスでのリアルタイム処理が困難でした。
手法・アプローチ
本研究では「SegAnyFruit」という段階的学習フレームワークを提案します。まず汎用セグメンテーションデータで事前学習し、次にWebから収集した多様な果実画像「WebFruits」で中間学習、最後に人間が検証した農業データ「PaperFruits」で微調整を行います。この過程で、基盤モデルの知識を軽量な検出器に蒸留します。推論時にはテキストプロンプトを必要とせず、YOLOやRF-DETRなどのアーキテクチャを用いて、高速かつ正確なマスク生成を実現します。
実験結果
7つのベンチマークで評価した結果、SAF-RF-DETR-XLモデルは平均Mask AP50:95で69.06を記録し、SAM 3を4.76ポイント上回りました。特に遮蔽の激しいトマトやイチゴのシーンで優位性を示しています。エッジデバイスJetson Orin NXでの推論速度は、RF-DETR-XLで30FPS、YOLO26m-segで69FPSを達成し、SAM 3の1.86FPSと比較して実用的なリアルタイム処理を可能にしました。
意義・応用可能性
SegAnyFruitは、少量のラベルデータでも迅速に新環境へ適応できる点が特徴です。1枚の画像での微調整でも高い精度を維持し、異なるドメインへの転移時の性能低下を抑制します。これにより、多品種を扱う果樹園や、季節ごとに変わる生育環境でのロボット運用コストを削減できます。公開される大規模データセットは、農業AI開発の標準ベンチマークとして活用される見込みです。
限界と今後の課題
現在のモデルは、極端に密集した果実や、葉と同化しやすい緑色の果実では依然として誤検出が残ります。また、学習データは主に可視光画像に基づいており、悪天候や夜間照明下でのロバスト性には改善の余地があります。今後の課題は、マルチスペクトル画像の活用や、さらに軽量なモデルへの蒸留を進め、低電力デバイスでの長時間稼働を実現することです。
日本での適用可能性
日本では、イチゴやトマトなどの施設園芸が盛んで、収穫ロボットの導入が進んでいます。SegAnyFruitのエッジ対応能力は、既存のロボットプラットフォームへの組み込みを容易にします。また、公開データセットには日本の農業環境に近いデータも含まれており、国内の品種特性に合わせた微調整が容易です。これにより、人手不足解消と高品質な選果自動化への貢献が期待されます。
📊 本論文の主な指標
参考論文
本記事は以下のarXiv論文を参考に、日本語に解説したものです。詳細は元論文をご覧ください。
– タイトル: SegAnyFruit: Learning Generalizable and Edge Deployable Fruit Instance Segmentation at Scale – 著者: Yanan Wang, Yuzheng wang, Yibin Ying, Zhenghao Fei – 発表日: 2026-11-19 – arXiv ID: 2611.25475v1 – カテゴリ: cs.CV